Uma janela grande resolve o problema?
Um modelo pode aceitar muitos documentos de uma vez. Isso informa quanto texto cabe na entrada, mas não prova que cada trecho será usado com a mesma qualidade. Em Lost in the Middle: How Language Models Use Long Contexts, pesquisadores perguntaram algo mais específico: a posição da informação relevante muda a resposta do modelo?
O estudo foi publicado em 2024 na revista TACL. Ele avaliou tarefas em que a resposta dependia de localizar evidência dentro de uma entrada longa. A pergunta não era se o modelo conseguia receber o conteúdo. Era se conseguia encontrar e usar a parte certa quando ela mudava de lugar.
Mover a evidência sem trocar a pergunta
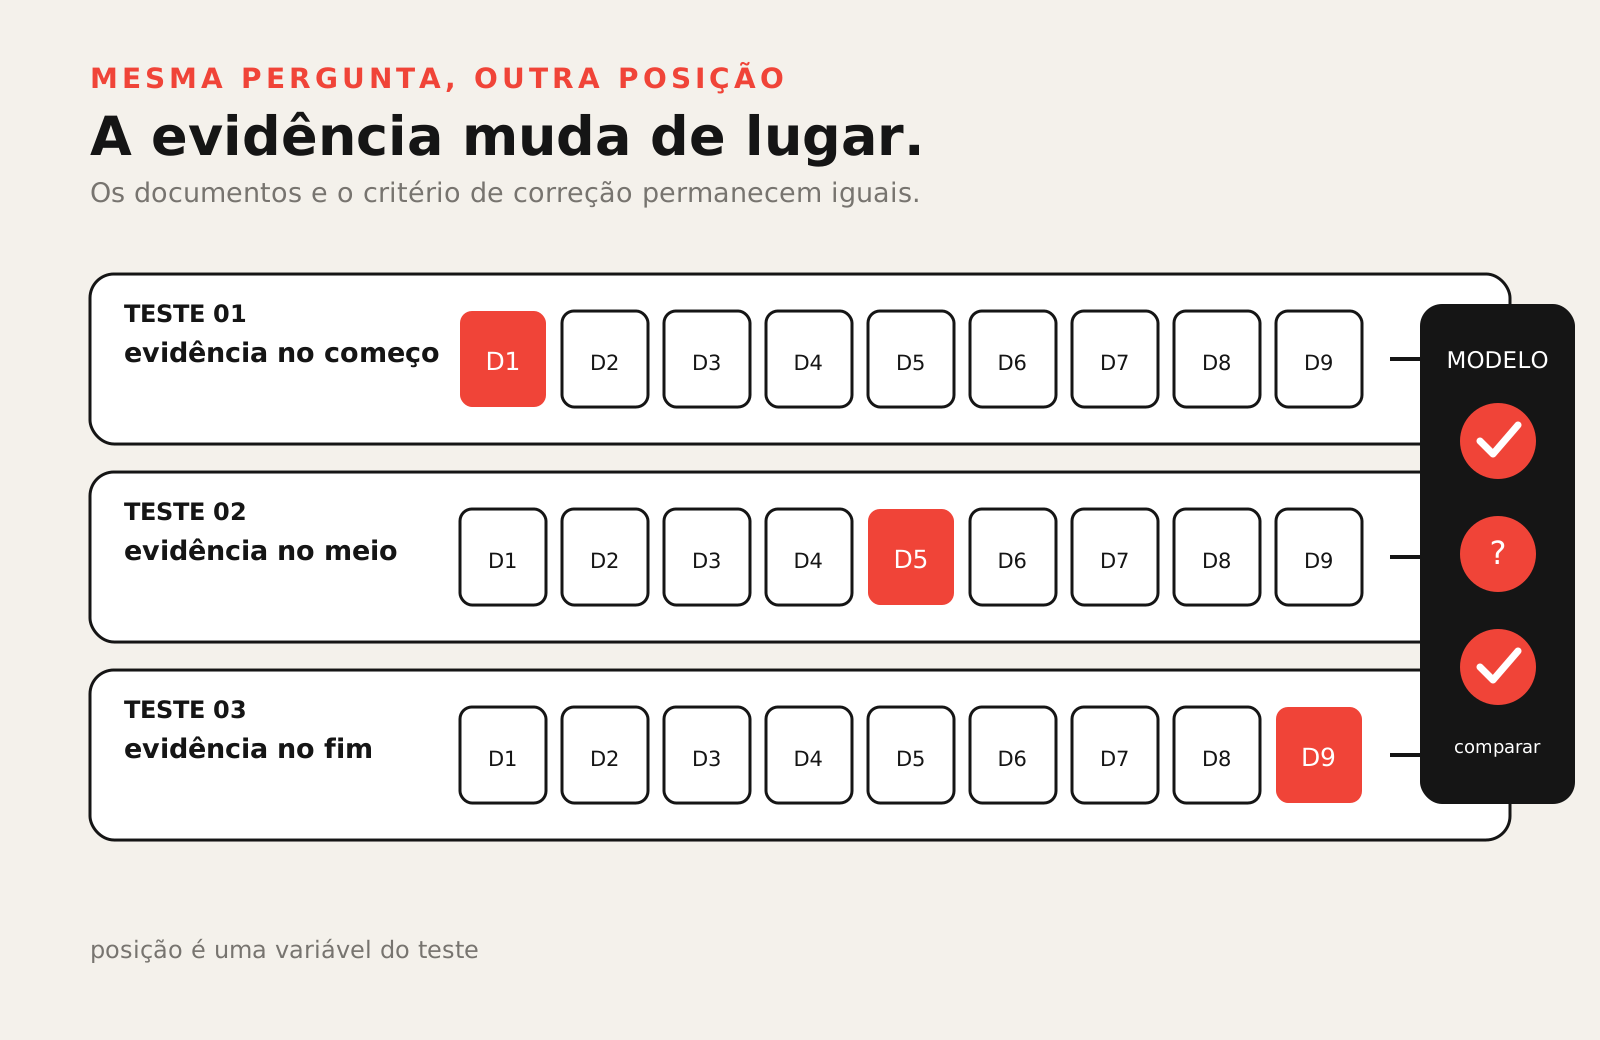
Imagine nove documentos enviados ao modelo. Apenas um contém o fato necessário para responder. No primeiro teste, esse documento aparece no começo. No segundo, fica no meio. No terceiro, vai para o fim. A pergunta e o conjunto de documentos permanecem. O que muda é a posição da evidência.
Os autores usaram essa lógica em perguntas com vários documentos e em uma tarefa controlada de recuperação. A segunda funciona como um índice: o modelo recebe pares de chave e valor e precisa devolver o valor ligado à chave pedida. Assim, fica mais fácil observar se a informação foi recuperada.
Contexto não funciona como um arquivo pesquisável
Um modelo de linguagem recebe o texto convertido em unidades menores chamadas tokens e produz a resposta passo a passo. O contexto condiciona essa geração, mas não oferece a garantia de uma consulta exata a cada trecho. Por isso, uma frase pode estar presente na entrada e ainda assim não influenciar a saída como o usuário esperava.
Essa diferença explica por que tamanho de contexto é uma especificação incompleta. Para um sistema real, também importam recuperação, posição, instrução, ruído dos outros documentos e avaliação da resposta. Um número grande informa capacidade de entrada. O teste informa se essa capacidade funciona na tarefa concreta.
O padrão observado formou uma curva
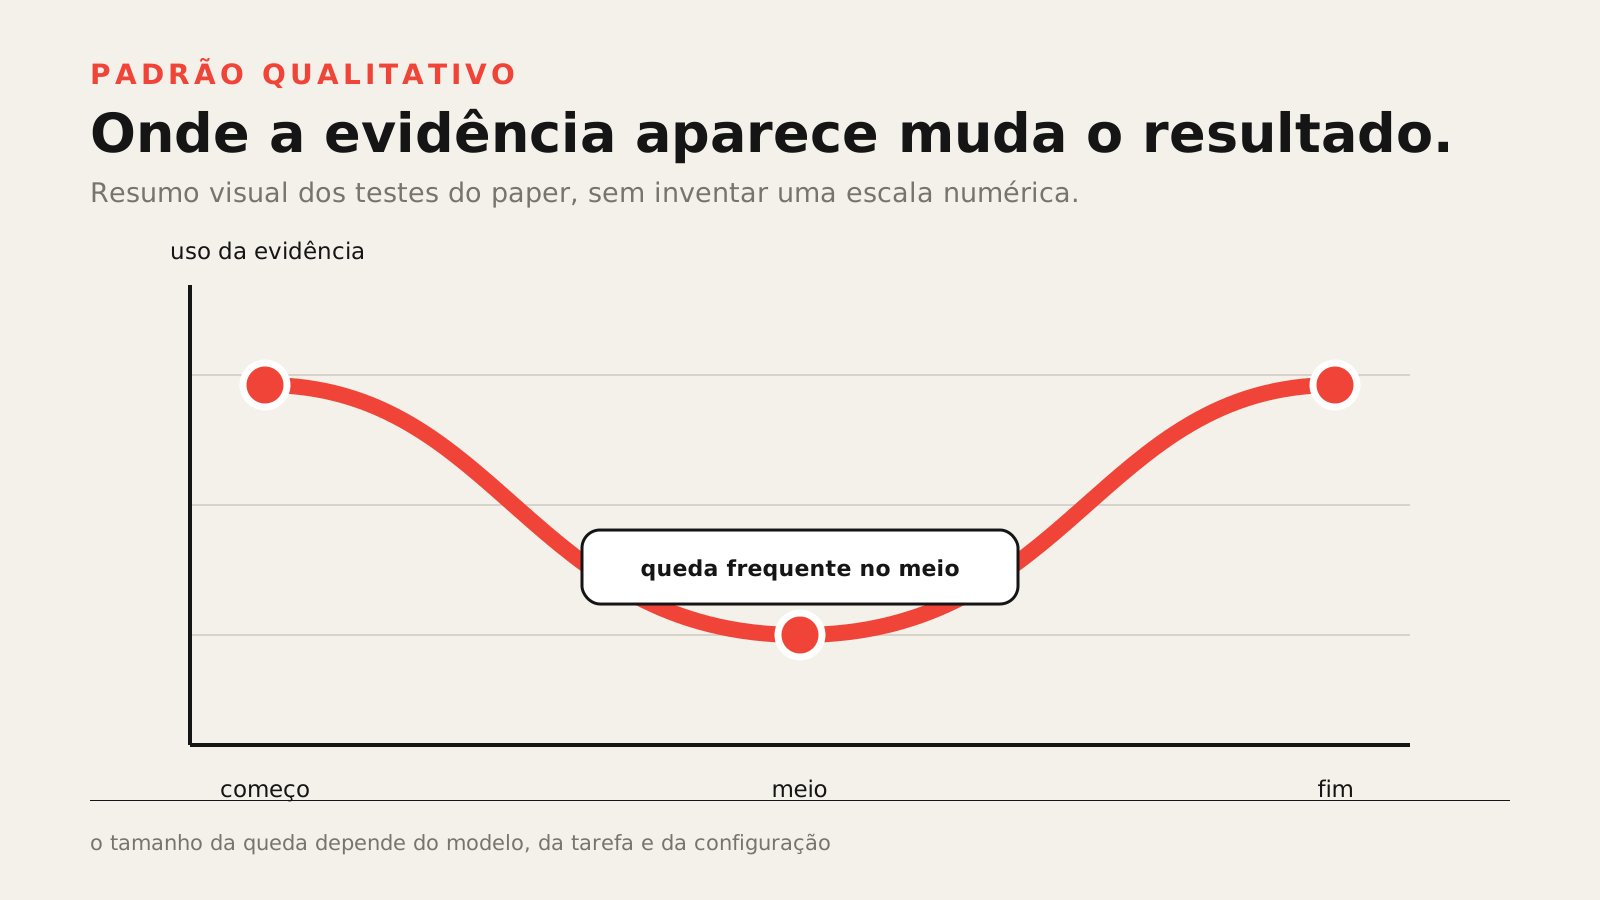
Nos modelos avaliados, o desempenho foi frequentemente melhor quando a informação relevante estava no começo ou no fim. Quando ela aparecia no meio de contextos longos, a qualidade podia cair de forma importante. O efeito também apareceu em modelos apresentados como capazes de trabalhar com contextos longos.
A distinção prática é simples: caber na janela de contexto e ser recuperado com robustez são capacidades diferentes. Colocar vinte arquivos numa conversa não garante que uma condição escondida no décimo arquivo terá o mesmo peso de uma instrução colocada logo no início.
O paper não criou uma lei eterna
Modelos, técnicas de recuperação e formas de organizar o contexto continuam mudando. Também existem tarefas diferentes das avaliadas. A conclusão responsável é usar o paper como alerta e método de teste, não como atalho para declarar que uma aplicação funciona ou falha.
Faça um teste pequeno no seu próprio sistema
- Escolha uma pergunta cuja resposta exista em apenas um dos documentos.
- Execute a pergunta com a evidência no começo, no meio e no fim.
- Mantenha modelo, instrução, documentos e critério de correção iguais.
- Repita algumas vezes e registre resposta correta, fonte citada e omissões.
Esse exercício não substitui um benchmark. Ele revela um comportamento local do seu fluxo. Se a posição mudar o resultado, você encontrou um risco observável e pode reorganizar documentos, dividir a tarefa, recuperar trechos relevantes antes da geração ou criar avaliações recorrentes.