A voz não escreve o software
Quando alguém fala com um agente de código, existem pelo menos três sistemas diferentes em ação. Uma ferramenta converte som em texto. Um modelo interpreta aquele texto dentro de algum contexto. Um agente pode usar arquivos, terminal ou outras ferramentas para executar uma tarefa. Chamar tudo de “programação por voz” é conveniente, mas esconde onde cada erro pode nascer.
A transcrição pode trocar o nome de uma variável. O modelo pode interpretar uma frase ambígua. O agente pode encontrar o arquivo errado. Nenhum desses problemas é resolvido falando mais rápido. A vantagem da voz aparece em outro lugar: explicar uma situação longa, corrigir o próprio raciocínio e fornecer contexto sem transformar a digitação no gargalo.
Por isso, falar com o modelo não é ditar código linha por linha. É narrar intenção e contexto para um sistema que precisa devolver uma interpretação verificável. A primeira saída útil não é o código. É um resumo fiel do que será feito e do que continuará fora do escopo.
Antes de pedir execução, confirme se a máquina ouviu a mesma tarefa que você pensou.
O que o meu painel realmente permite afirmar
Em 1º de setembro de 2026, quatro números do meu painel do Wispr Flow mostravam que a voz já era uma entrada recorrente para interações com IA: 636.426 palavras ditadas, média de 126 palavras por minuto, 4.339 prompts para IA e 67% do uso classificado no desktop associado a prompts.
volume acumulado mostrado pelo aplicativo.
palavras por minuto no painel.
interações classificadas pela ferramenta.
da atividade no desktop ligada a prompts.
Esses números medem volume e hábito. Não medem quantos projetos foram construídos, quanto tempo foi economizado nem que parcela de um sistema veio da voz. Também não autorizam reproduzir conversas, nomes de terceiros ou detalhes de projetos privados. A conclusão responsável é menor e mais útil: a voz deixou de ser ocasional e passou a sustentar muitas interações com ferramentas de IA.
Uma contagem de palavras não é uma contagem de resultados.
Para saber se a voz melhora o trabalho, seria necessário comparar tarefas equivalentes, qualidade, tempo de revisão, erros e consequência — não apenas quantidade de fala.
O Wispr prepara a entrada; o agente interpreta
A documentação atual do Wispr Flow mostra recursos desenhados para reduzir erros comuns na conversa com ferramentas de código. O aplicativo pode reconhecer nomes em camelCase e snake_case, preservar termos de terminal e anexar arquivos por voz em chats do Cursor e do Windsurf. Snippets permitem transformar uma frase curta num bloco reutilizável.
Esses recursos melhoram a transcrição e a seleção de contexto. Eles não sabem se o arquivo anexado é canônico, se a regra de negócio está correta ou se uma alteração pode chegar a usuários reais. A ferramenta de voz organiza a mensagem. O modelo interpreta. O agente age dentro das permissões que recebeu. A pessoa continua responsável por reconhecer o resultado.
Use a voz em duas passagens
A fala natural é boa para explorar, mas pode misturar pedido, hipótese, correção e comentário. Uma técnica simples separa riqueza de contexto de autorização. Na primeira passagem, a pessoa narra o problema com liberdade. Na segunda, o agente devolve um resumo curto e espera confirmação.
-
Narrar
Explique o que aconteceu, o resultado desejado, as dúvidas e os limites conhecidos.
-
Limpar
A ferramenta remove hesitações sem acrescentar uma decisão que não foi falada.
-
Espelhar
O agente resume objetivo, contexto, escopo e pontos ainda ambíguos.
-
Confirmar
A pessoa corrige o resumo ou libera somente a próxima ação delimitada.
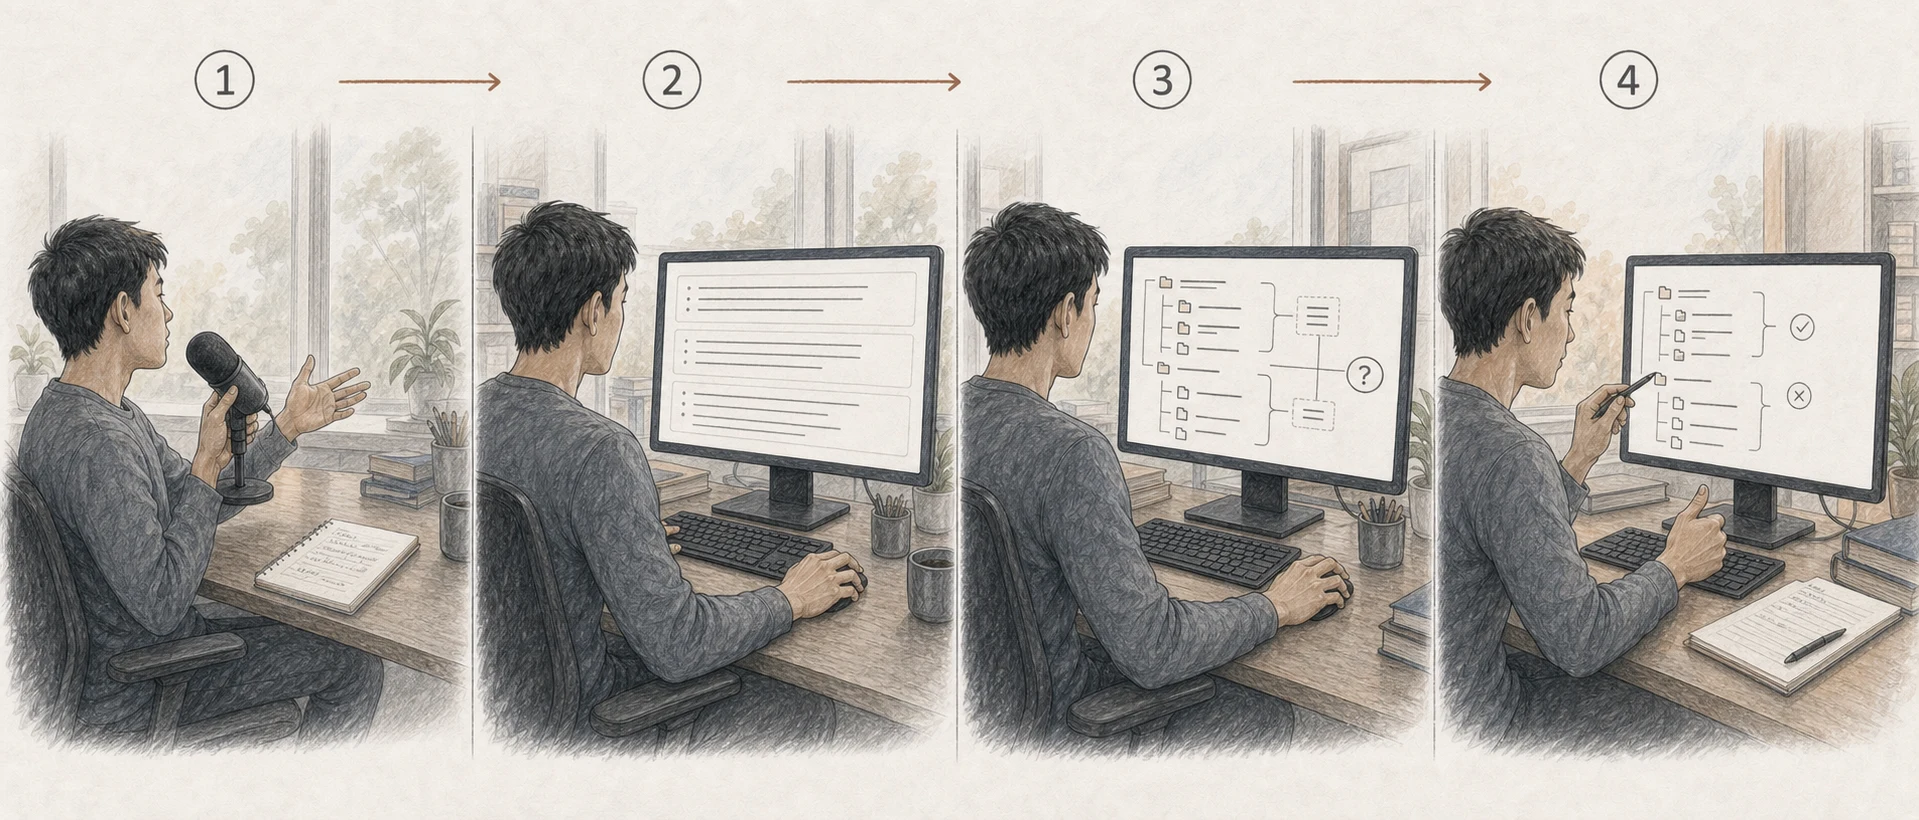
Essa separação ajuda especialmente em pedidos longos. Se a transcrição trocou um nome, se duas restrições entram em conflito ou se o agente escolheu uma interpretação inesperada, o erro aparece no resumo. Corrigir uma frase custa menos do que desfazer arquivos alterados a partir dela.
Três pessoas podem usar voz por motivos diferentes
O engenheiro Jeremy Rose, que trabalha no Codex, usa voz depois de conviver com uma lesão por esforço repetitivo. No relato publicado pela OpenAI, a interface falada participa de tarefas normais de engenharia, como investigar logs, raciocinar sobre casos ausentes e construir software. A experiência técnica continua presente; a voz reduz a dependência física do teclado.
Colin Knudsen, da Proaction, não é engenheiro. Ele usa Codex por voz para transformar conversas com clientes em demonstrações dentro de ambientes isolados e com dados fictícios. Depois, a equipe de engenharia recebe o protótipo e o contexto para construir a versão segura. Nesse caso, a voz aproxima descoberta e prototipagem, enquanto o sandbox preserva a fronteira com produção.
Equipes de engenharia também usam agentes para reunir contexto, executar tarefas delimitadas e trabalhar em paralelo. O caso da Ramp publicado pela Anthropic descreve integração com testes, documentação e observabilidade. É um relato de fornecedor, não uma prova universal. Ele mostra, porém, que o valor não está apenas no prompt: aparece quando o agente encontra um sistema capaz de verificar sua contribuição.
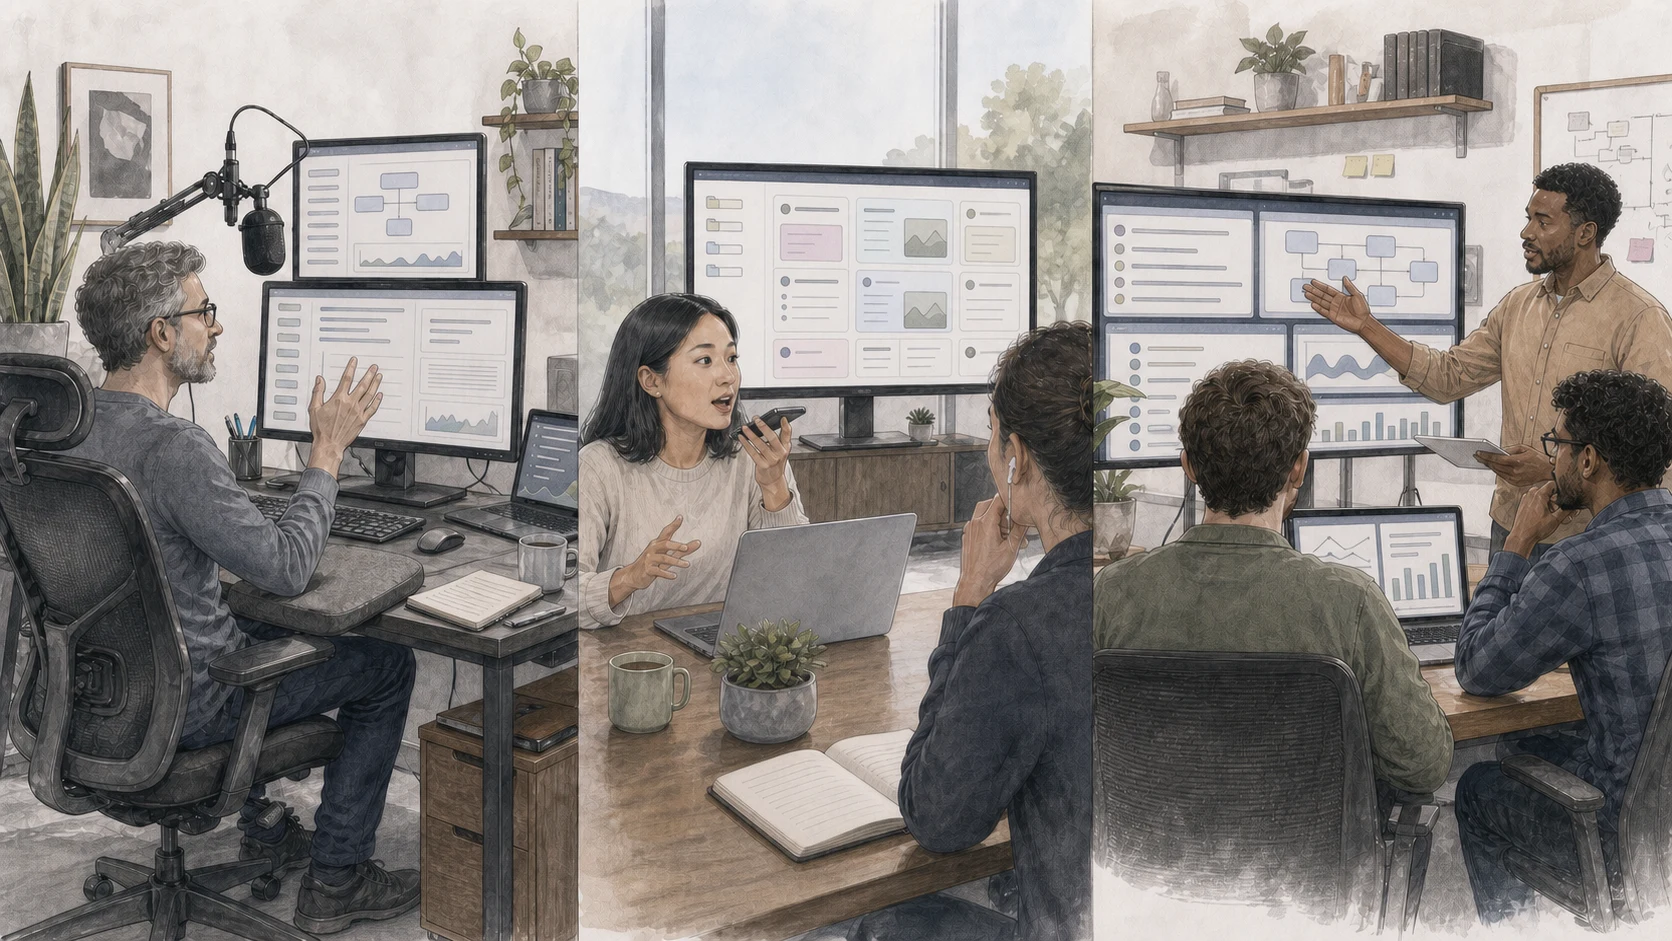
A fala reduz esforço físico sem remover a experiência de quem avalia o sistema.
Dados fictícios e sandbox permitem aprender sem confundir demonstração com produto.
Ferramentas existentes oferecem fontes e sinais que tornam a saída verificável.
Explicações e perguntas revelam lacunas antes de uma tentativa virar implementação.
Conhecimento de engenharia funciona como compressão
Uma pessoa experiente não precisa ditar mais palavras para dar mais contexto. Ela consegue nomear uma fronteira: API, banco, autenticação, cache, branch, ambiente, migração. Cada termo comprime uma família de consequências. Também permite perceber quando o resumo do agente trocou o mecanismo do problema por uma solução conveniente.
Isso não significa que iniciantes não possam programar por voz. Significa que o nível de autonomia deve acompanhar a capacidade de reconhecer erro. Explicar código, estudar uma função e montar um protótipo descartável exigem menos proteção. Alterar autenticação, pagamentos, dados pessoais ou infraestrutura compartilhada exige alguém capaz de revisar aquelas fronteiras.
A voz aumenta largura de banda; conhecimento aumenta discernimento.
Uma instrução longa pode continuar errada. O ganho aparece quando a fala oferece contexto que uma pessoa sabe confrontar com o sistema real.
Fluência não é garantia de correção.Os erros próprios da voz
A programação falada cria falhas que um prompt digitado torna menos prováveis. O nome de um arquivo pode soar como uma palavra comum. Uma autocorreção pode preservar duas versões contraditórias da mesma decisão. Uma frase longa pode esconder a única restrição importante. E um ambiente com outras pessoas pode transformar privacidade em parte do problema.
Confirme arquivos, variáveis, números e comandos antes de anexá-los à tarefa.
Peça uma versão limpa e única do escopo, não uma transcrição cronológica.
Espere o resumo do agente antes de permitir qualquer mudança.
Não dite segredos, dados pessoais ou conteúdo de terceiros sem necessidade e proteção.
A pesquisa não sustenta uma promessa simples
A pesquisa de 2025 do Stack Overflow mostra ampla adoção de IA no desenvolvimento, mas confiança limitada: 46% das pessoas respondentes desconfiavam da precisão das respostas, contra 33% que confiavam. A frustração mais citada era receber uma solução quase certa. A maioria também dizia que vibe coding não fazia parte do trabalho profissional.
O DORA descreve IA como amplificador: boas práticas ficam mais poderosas; fragilidade e desordem também. Estudos da METR encontraram resultados diferentes conforme ferramentas, tarefas e desenho do experimento, inclusive dificuldade para medir pessoas usando vários agentes ao mesmo tempo. Nenhuma dessas fontes permite concluir que falar com um agente produz um multiplicador universal de produtividade.
Para medir a voz com honestidade, compare tarefas equivalentes: tempo até um escopo confirmado, quantidade de correções de transcrição, qualidade da saída e esforço de revisão. Se falar produz pedidos mais ricos e menos desgaste, já existe valor. Se apenas aumenta o volume de tentativas, o gargalo foi deslocado.
Um teste pequeno para começar
Use voz primeiro numa tarefa sem consequência externa
- Narre um problema que você já entende.
- Não autorize edição na primeira mensagem.
- Peça ao agente um resumo de quatro linhas.
- Confirme nomes e limites manualmente.
- Compare com o pedido que você digitaria.
- Registre onde a voz ajudou e onde confundiu.
O objetivo não é abandonar o teclado. É descobrir em que parte do trabalho a fala aumenta contexto, acessibilidade ou clareza. Para algumas pessoas será a exploração inicial. Para outras, a revisão de uma ideia durante uma caminhada. Para quem sente dor ao digitar, pode ser a diferença entre parar e continuar construindo.
A ideia que fica
Voz, modelo e agente não são a mesma coisa. A voz captura intenção. O modelo interpreta. O agente pode agir. Separar essas camadas torna possível corrigir o entendimento antes que uma frase ambígua alcance arquivos ou sistemas.
Conhecimento de engenharia continua importante porque ajuda a nomear fronteiras e reconhecer consequência. Mas a voz amplia quem consegue expressar uma ideia técnica, reduz desgaste e permite oferecer mais contexto. O uso responsável combina as duas coisas: fala natural na entrada e confirmação rigorosa antes da ação.
O melhor primeiro resultado de um prompt falado é um entendimento que você consegue corrigir.