Não comece pelo nome do modelo
Existe uma pergunta que aparece toda vez que uma nova inteligência artificial é lançada: qual é a melhor? A pergunta parece prática, mas começa no lugar errado. Uma ferramenta pode ser excelente para analisar documentos e inadequada para editar um repositório. Um modelo pode responder rapidamente a uma pergunta simples e falhar numa pesquisa que exige fontes atuais. Um agente pode operar arquivos e terminal, mas essa capacidade não significa que ele tenha autorização para publicar ou apagar alguma coisa.
Por isso, eu não começo pelo nome do modelo. Começo pela tarefa. O que precisa ser produzido? Que contexto a IA precisa acessar? O resultado deve trazer fontes? Existe alguma ação no mundo real? Quanto custa um erro? Somente depois dessas respostas faz sentido escolher aplicativo, modo, modelo e ferramentas.
Não existe uma IA melhor para tudo. Existe uma combinação mais adequada para uma tarefa, dentro de um risco e de um critério de sucesso.
Quatro coisas que costumam ser chamadas de “IA”
Quando alguém diz “estou usando uma IA”, pode estar falando de componentes diferentes. Misturá-los dificulta entender por que duas experiências com o mesmo modelo podem produzir resultados tão distintos.
Recebe texto, imagem, áudio ou vídeo e calcula uma resposta.
Organiza conversa, arquivos, histórico, busca e integrações.
Pode priorizar velocidade, raciocínio, pesquisa ou execução agente.
Navegador, arquivos, terminal, GitHub, calendário, e-mail ou API.
O modelo é o mecanismo que recebe uma entrada e produz uma saída. Ele pode trabalhar com texto, imagem, áudio, vídeo ou uma combinação desses formatos. Modelos variam em capacidade de raciocínio, velocidade, custo, tamanho de contexto e especialização. O modelo, porém, não define sozinho a experiência completa. Ele pode estar dentro de um aplicativo que oferece busca na web, memória, edição de arquivos ou acesso a ferramentas.
O aplicativo é a superfície pela qual usamos a IA. O modo indica como o sistema organiza o trabalho: uma resposta rápida, um raciocínio com várias etapas, uma pesquisa com fontes ou uma execução agente. Ferramenta é aquilo que o sistema consegue consultar ou operar. Um modelo pode saber explicar programação sem conseguir abrir um repositório. Um agente com terminal e testes consegue confrontar a explicação com o código real.
Descubra qual componente limita a tarefa
Modelo produz a saída. Aplicativo oferece a interface. Modo organiza o esforço. Ferramentas conectam o sistema ao contexto e às ações. Antes de comparar marcas, descubra qual dessas camadas está impedindo o resultado de ser útil e verificável.
Um projeto pode exigir escolhas diferentes
Imagine que você queira publicar uma página para apresentar um novo serviço. Primeiro, é necessário entender o público e confrontar informações atuais. Essa parte pede pesquisa com fontes. Depois, alguém precisa organizar a tese e escrever o texto. Aqui, um assistente generalista pode ajudar. Em seguida, o código precisa ser criado dentro de um repositório existente. Agora, contexto do projeto, terminal e testes se tornam essenciais. Por fim, uma imagem precisa ser produzida e revisada visualmente.
É o mesmo projeto, mas não é a mesma tarefa. Usar uma única conversa para pesquisar, escrever, programar, gerar a imagem e publicar tudo parece conveniente. Também mistura objetivos, contextos e autoridades. Uma fonte pode desaparecer no resumo e a mesma ferramenta que propôs uma mudança pode acabar aprovando a própria proposta.
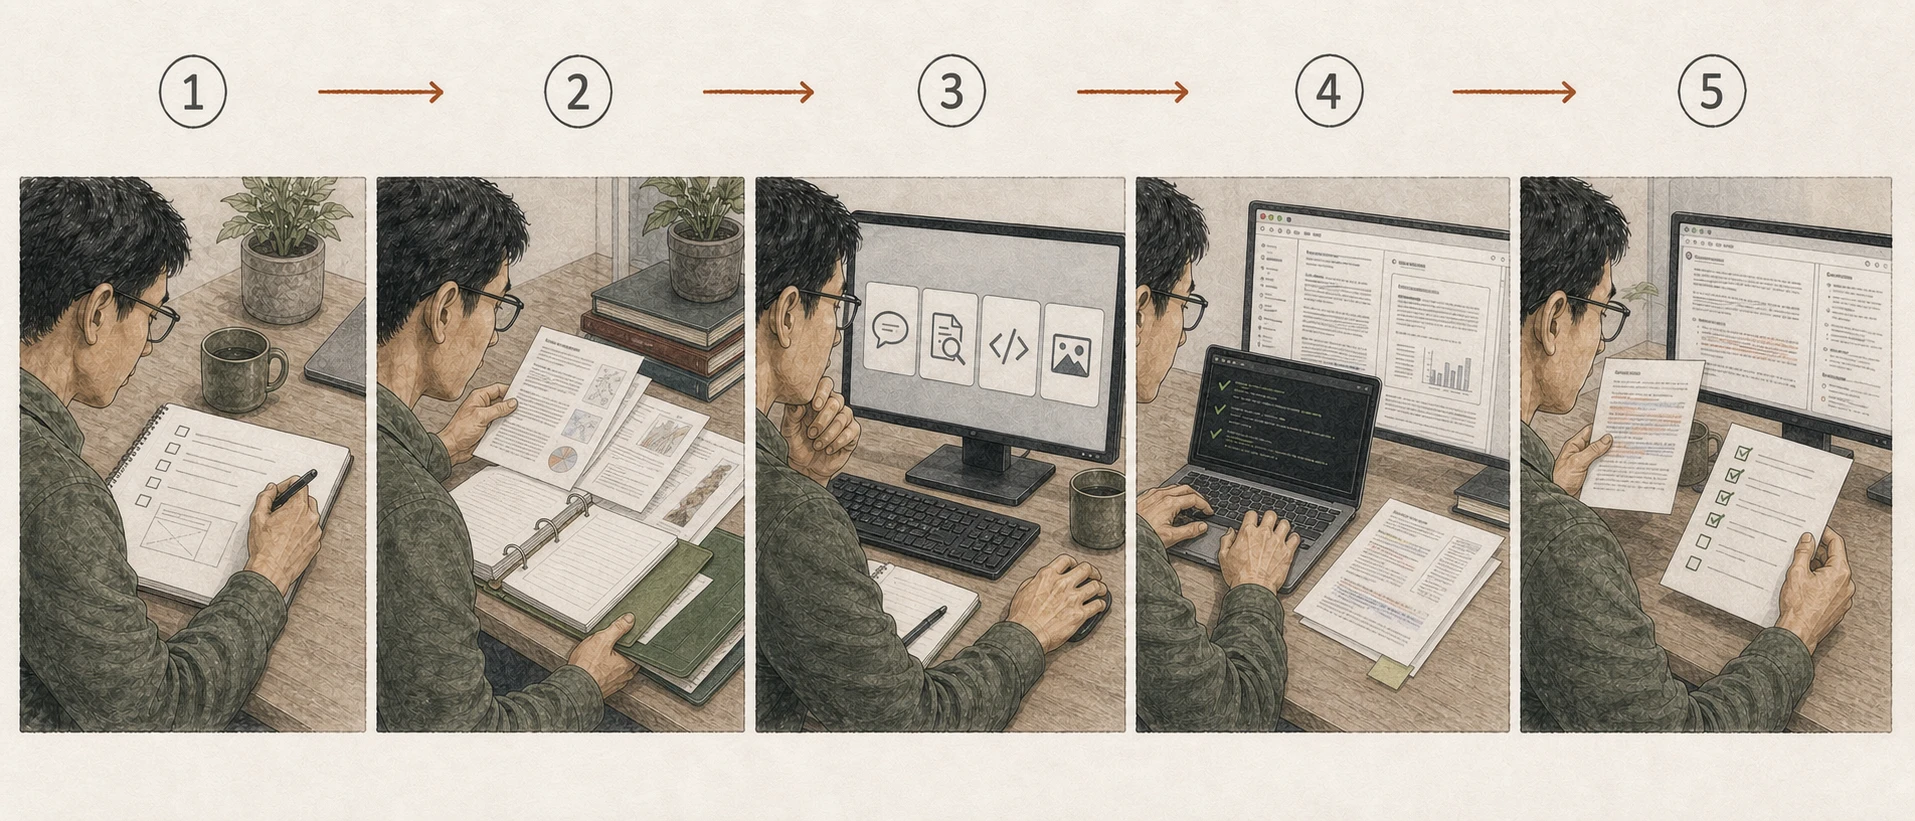
Uma etapa não deve aprovar silenciosamente a seguinte
- Pesquisa reúne evidências
- Escrita organiza a explicação
- Programação implementa
- Testes confrontam o comportamento
- Revisão autoriza a consequência
Essa separação não exige cinco empresas diferentes. Ela exige que cada etapa tenha o modo, o contexto, as ferramentas e os critérios de sucesso apropriados.
Qual modelo usar?
Minha regra inicial é simples: comece com a opção equilibrada e só aumente ou reduza a capacidade quando a tarefa mostrar necessidade. Um modelo rápido e econômico costuma ser suficiente para classificar textos, reformatar dados, criar variações curtas ou executar instruções repetitivas e bem definidas. Um modelo com raciocínio mais profundo faz sentido quando existem dependências, ambiguidades, decisões técnicas ou várias restrições que precisam ser consideradas juntas.
Quando a resposta depende de fatos recentes, acesso à pesquisa e às fontes importa mais do que a memória do modelo. Quando o resultado é uma imagem, voz ou vídeo, um modelo especializado oferece controles mais adequados. Quando a tarefa exige modificar um sistema real, é necessário observar também o ambiente do agente: arquivos, permissões, ferramentas e possibilidade de desfazer.
| Trabalho | Ponto de partida |
|---|---|
| Resumo, organização ou primeira versão | Modelo generalista em modo rápido |
| Problema difícil com várias etapas | Modelo mais capaz em modo de raciocínio |
| Informação atual ou afirmação verificável | Pesquisa com acesso à web e fontes |
| Programação dentro de um projeto real | Agente com repositório, terminal, diff e testes |
| Criação ou edição visual | Modelo especializado em imagem ou vídeo |
| Conversa por voz e transcrição | Modelo especializado em áudio e tempo real |
| Processo recorrente entre sistemas | Workflow ou agente com ferramentas e limites explícitos |
| Dados privados ou sensíveis | Ambiente com política adequada de acesso, retenção e auditoria |
Comece com a opção mais simples que possa demonstrar o resultado
Aumente raciocínio, contexto ou autonomia somente quando a tarefa exigir. Capacidade adicional também traz mais custo, espera e espaço para ações desnecessárias.
A melhor resposta pode vir da ferramenta menos inteligente
Suponha que você queira saber o total de uma coluna numa planilha. Um modelo avançado pode interpretar os dados, explicar a operação e sugerir uma fórmula. Ainda assim, a própria função de soma da planilha é mais previsível, barata e verificável.
O mesmo acontece com regras de negócio. Se toda compra acima de determinado valor precisa de revisão, uma condição explícita pode ser melhor do que um modelo probabilístico. Se um dado já existe num banco estruturado, uma consulta correta pode ser melhor do que pedir para um chatbot tentar lembrá-lo. Usar IA não é o objetivo. Resolver a tarefa é o objetivo.
O que está disponível no Brasil hoje?
A tabela abaixo reúne planos individuais que podem ser usados no Brasil e foi conferida em 31 de agosto de 2026. O Google publica preços locais diretamente em reais. Os demais fornecedores exibem referências em dólar; para torná-las comparáveis, converti os valores pela PTAX de venda do Banco Central do Brasil de R$ 5,1816 por US$ 1.
O símbolo “≈” indica conversão, não o valor final da fatura. Impostos, IOF, preço localizado, promoção, cobrança anual e loja de aplicativos podem alterar o total. A OpenAI já aceita cobrança em reais e Pix no Brasil, mas o checkout pode apresentar um preço localizado diferente da simples conversão cambial.
| Aplicativo | Planos individuais | Modelos e recursos principais | Quando faz sentido |
|---|---|---|---|
| ChatGPT | Free: R$ 0 Go: ≈ R$ 41,45 Plus: ≈ R$ 103,63 Pro: a partir de ≈ R$ 518,16 |
Free e Go usam GPT-5.6 Luna e Thinking Mini; Plus acrescenta GPT-5.6 Sol e Terra; Pro inclui Sol Pro e limites maiores. Busca, arquivos, imagens, voz, pesquisa profunda e Codex variam por plano. | Uso generalista, pesquisa, escrita, análise de arquivos, imagem e programação no mesmo ecossistema. |
| Claude | Free: R$ 0 Pro mensal: ≈ R$ 103,63 Pro anual: ≈ R$ 86,36/mês, com US$ 200 pagos antecipadamente Max: a partir de ≈ R$ 518,16 |
Famílias Haiku, Sonnet, Opus e Fable, conforme plano e disponibilidade. Pro inclui Claude Code, Research e projetos; Max aumenta os limites. | Leitura e escrita longas, análise, pesquisa e programação com Claude Code. |
| Google AI | Plus: R$ 24,99 Pro: R$ 96,99 Ultra 5x: R$ 779,90 Ultra 20x: R$ 999,90 |
Gemini, modelos Pro, Deep Think, Nano Banana Pro, Omni Flash, Deep Research e agentes de programação; acesso e limites variam por plano. | Quem trabalha no Gmail, Documentos, Drive, Notebook e demais serviços do Google. |
| Perplexity | Free: R$ 0 Pro: ≈ R$ 103,63 Max: ≈ R$ 1.036,32 |
Aplicativo de pesquisa que combina busca, fontes e modelos de diferentes fornecedores. Planos pagos aumentam limites e conectores. | Pesquisa atual, descoberta de fontes e síntese quando a rastreabilidade é central. |
| GitHub Copilot | Free: R$ 0 Pro: ≈ R$ 51,82 Pro+: ≈ R$ 202,08 Max: ≈ R$ 518,16 |
Seleção de modelos da OpenAI, Anthropic, Google e outros dentro de IDE, CLI, GitHub, revisão de código e agentes. O conjunto depende do plano e do recurso. | Programação centrada no repositório, com conclusão, chat, agentes e revisão de código. |
Preço de assinatura não é preço de API. Um plano para pessoas inclui limites e aplicativos; uma API cobra pelo uso do modelo e pode acrescentar busca, armazenamento, execução ou infraestrutura.
Modelos abertos: baixar não significa custo zero
“Open source” é usado de forma ampla no mercado, mas não significa sempre a mesma coisa. A Open Source Initiative exige liberdade para usar, estudar, modificar e compartilhar o sistema, além de informações e código suficientes para compreender como ele foi produzido. Muitos lançamentos chamados de open source oferecem principalmente os pesos treinados. O termo mais preciso nesses casos é open weights, ou pesos abertos.
Pesos disponíveis para download podem ser usados no Brasil sem uma assinatura do aplicativo. Isso não torna a operação gratuita. É preciso pagar ou possuir memória, GPU, armazenamento, energia, hospedagem e trabalho de manutenção. Também é necessário ler a licença de cada família antes de modificar, redistribuir ou usar comercialmente.
| Família | Grau de abertura | Licença ou termos | Uso prático |
|---|---|---|---|
| OLMo 2 | Sistema amplamente aberto: pesos, dados, código, receitas, avaliações e checkpoints. | Componentes principais sob licenças abertas, incluindo Apache 2.0. | Pesquisa, auditoria, reprodução de treinamento e estudo de transparência. |
| gpt-oss 20B e 120B | Pesos abertos; não fazem parte da API nem do ChatGPT. | Apache 2.0 mais política de uso do gpt-oss. | Raciocínio, ferramentas e execução em infraestrutura própria ou hospedada. |
| Qwen3 | Família de pesos abertos com vários tamanhos e modos de instrução ou raciocínio. | Apache 2.0 nos modelos publicados pelo projeto. | Execução local, adaptação, uso multilíngue e experimentação com diferentes tamanhos. |
| DeepSeek-R1 | Código e pesos disponibilizados; variantes destiladas podem herdar licença do modelo-base. | MIT para R1; verificar cada variante derivada. | Raciocínio, pesquisa e estudo de destilação em infraestrutura própria. |
| Mistral Small 4 | Pesos abertos para um modelo multimodal com raciocínio e programação. | Apache 2.0. | Aplicações gerais, visão, agentes de código e implantação customizada. |
| Gemma 4 | Pesos abertos em tamanhos voltados de dispositivo móvel a servidor. | Apache 2.0. | Aplicações locais, multimodais, edge e ajuste para tarefas específicas. |
| Llama 4 | Pesos abertos, mas não é open source segundo o critério completo da OSI. | Licença comunitária e política de uso próprias. | Ecossistema amplo de ferramentas, ajustes e provedores de hospedagem. |
Para começar localmente, o tamanho é tão importante quanto o nome. Um modelo menor e quantizado pode funcionar num computador pessoal. Modelos maiores podem exigir uma GPU dedicada ou um provedor de nuvem. A escolha volta ao mesmo ponto: tarefa, contexto, evidência, custo e risco.
Seis critérios para escolher sem seguir hype
O sistema produz o formato necessário e consegue operar no ambiente correto?
Recebeu documentos, arquivos, dados e instruções suficientes?
Fontes, diff, testes ou comparação permitem verificar a saída?
Os dados e as ações respeitam permissões, retenção e responsabilidade?
A qualidade adicional justifica espera e consumo para aquela consequência?
Fontes, instruções e critérios podem ser levados para outra opção?
Uma ferramenta de conversa pode explicar uma imagem, mas isso não a torna automaticamente a melhor opção para editar pixels com precisão. Um chatbot pode gerar código, mas não substitui um ambiente que execute e teste esse código. Quando o trabalho depende de um repositório, de uma planilha ou de uma política interna, acesso correto pode importar mais do que alguns pontos num benchmark.
O nível de revisão deve acompanhar a consequência. Uma resposta melhor pode não justificar dez vezes mais espera para uma tarefa rotineira. O inverso também acontece: economizar alguns segundos não compensa quando o erro pode afetar dinheiro, dados, segurança ou produção.
Não compare modelos com perguntas de demonstração
Perguntar a dois modelos “qual é a capital da França?” mede muito pouco. Ambos provavelmente responderão Paris. Isso não revela qual deles funciona melhor no seu trabalho. Uma comparação útil começa com uma tarefa real e um resultado esperado.
Imagine a análise de três contratos para localizar cláusulas de cancelamento, citar cada trecho e produzir uma tabela com arquivo, página, prazo e dúvida aberta. Antes de executar, defina o que conta como sucesso. A ferramenta encontrou todas as cláusulas? Citou o trecho e a página correta? Separou fato, inferência e ausência de informação? Respeitou o formato? Quanto tempo levou? Foi fácil corrigir ou repetir?
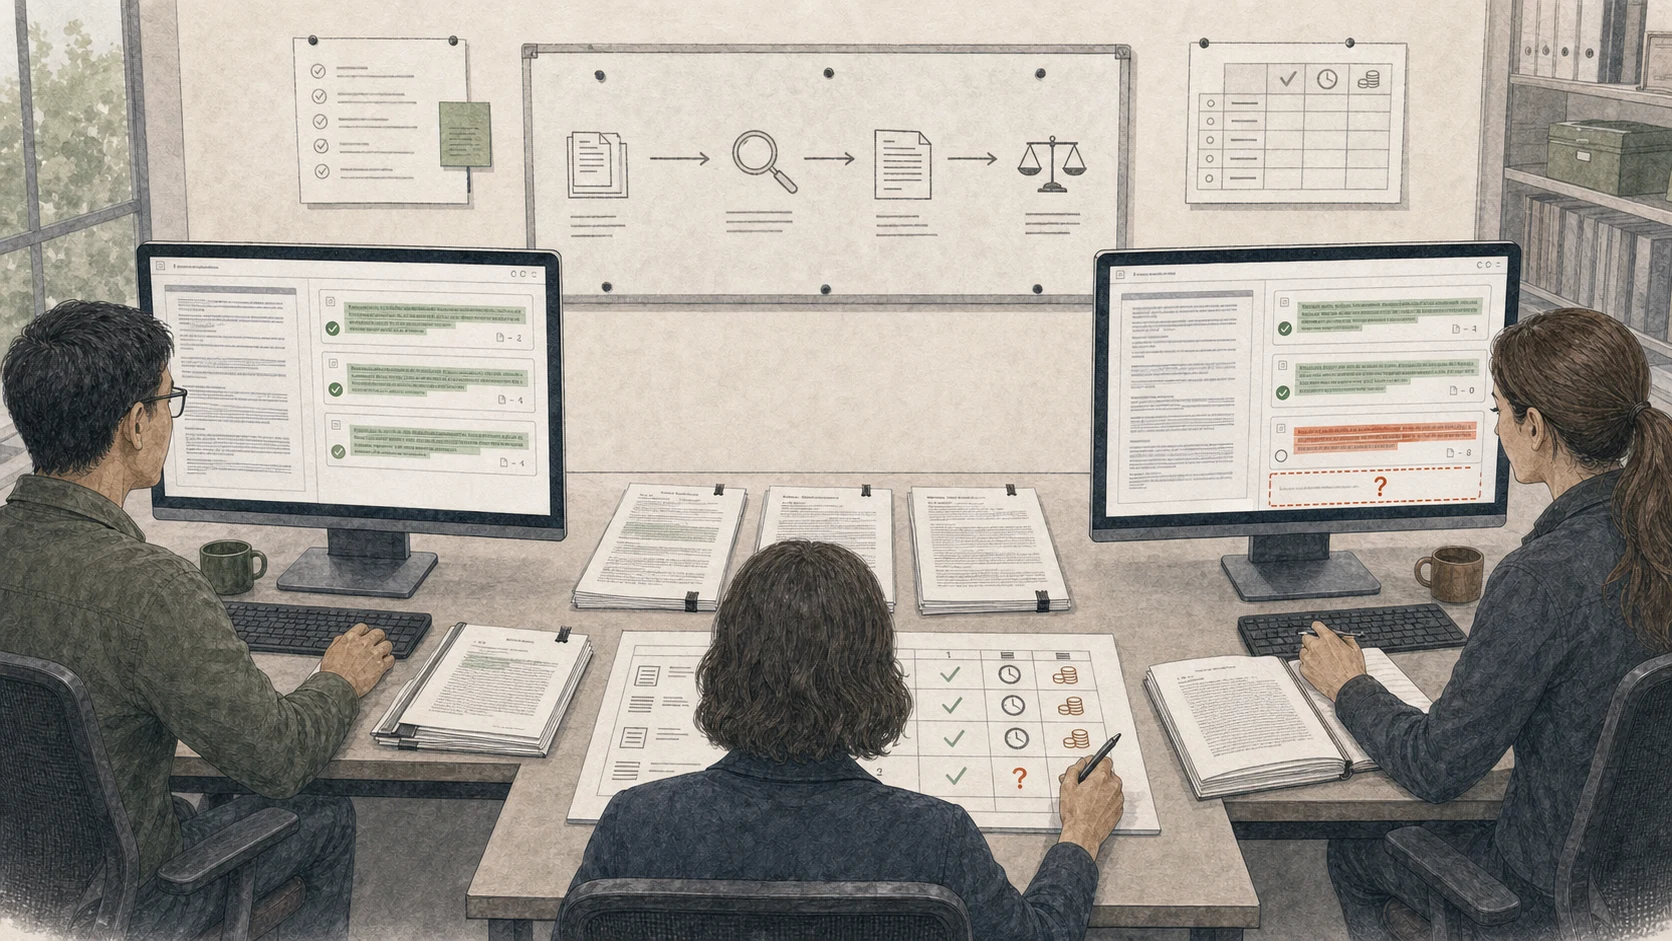
Compare comportamento observável
Execute uma tarefa real com as mesmas entradas. Compare cobertura, evidência, tempo, custo e facilidade de correção. Preferência pessoal vem depois da observação, não antes.
O nome do modelo não explica o sistema inteiro
Uma resposta pode melhorar porque o fornecedor trocou o modelo. Também pode melhorar porque o aplicativo passou a buscar na web, recebeu mais contexto, ganhou memória, conectou ferramentas ou adicionou uma etapa de verificação. Por isso, “qual modelo você usou?” é apenas uma das perguntas.
- Qual aplicativo e qual modo?
- Quais ferramentas estavam disponíveis?
- Que contexto foi enviado?
- Havia memória de conversas anteriores?
- Quem revisou a saída?
- Alguma ação foi executada?
Sem essas respostas, comparar apenas o nome do modelo pode produzir uma conclusão errada. Uma resposta eloquente sem contexto continua sendo uma tentativa. Uma resposta com fontes, testes e possibilidade de correção se torna parte de um sistema verificável.
Quando eu troco de ferramenta
Eu não troco apenas porque apareceu um lançamento. Troco quando o trabalho mostra um limite observável. Talvez a ferramenta não consiga acessar as fontes necessárias. Talvez a resposta não preserve citações. Talvez o agente altere arquivos demais. Talvez a política de dados não seja compatível com o conteúdo. Ou talvez outra opção produza o mesmo resultado com menos passos e mais controle.
O motivo da troca deve ser descrito como comportamento, não como torcida: “esta opção encontrou os trechos e preservou as páginas; a anterior perdeu duas referências”. Isso é mais útil do que “o modelo novo parece mais inteligente”.
Troque quando o limite aparecer no trabalho
Falta de contexto, evidência, controle, privacidade, velocidade ou custo adequado são motivos observáveis. Um benchmark, um influenciador ou um lançamento não declara um vencedor universal.
Uma escolha boa continua precisando de revisão
Escolher a ferramenta certa reduz atrito. Não elimina erro. Modelos podem inventar informações, interpretar uma instrução de forma diferente, usar uma fonte fraca ou produzir confiança sem correspondência com a realidade. Agentes podem executar a tarefa correta no lugar errado. Aplicativos podem esconder decisões importantes atrás de uma interface simples.
Um rascunho descartável tolera mais exploração. Uma pesquisa publicada exige fontes. Código de produção exige testes e revisão. Uma ação que envolve dinheiro, dados pessoais ou permissões exige autoridade clara e mecanismos de reversão.
A ideia que fica
A melhor ferramenta não é a que aparece no topo de uma tabela. É a que resolve uma tarefa definida, dentro do contexto necessário, com evidência suficiente e risco controlado.
Comece pelo trabalho. Identifique o formato de saída. Descubra quais dados e ferramentas são necessários. Escolha o modo e o nível de capacidade. Defina como o resultado será verificado. Depois compare opções reais. Assim, novos modelos deixam de ser uma fila infinita de lançamentos que você precisa acompanhar. Eles viram alternativas dentro de um método que você já controla.
Escolha a tarefa primeiro; modelo, aplicativo, modo e ferramentas vêm depois.