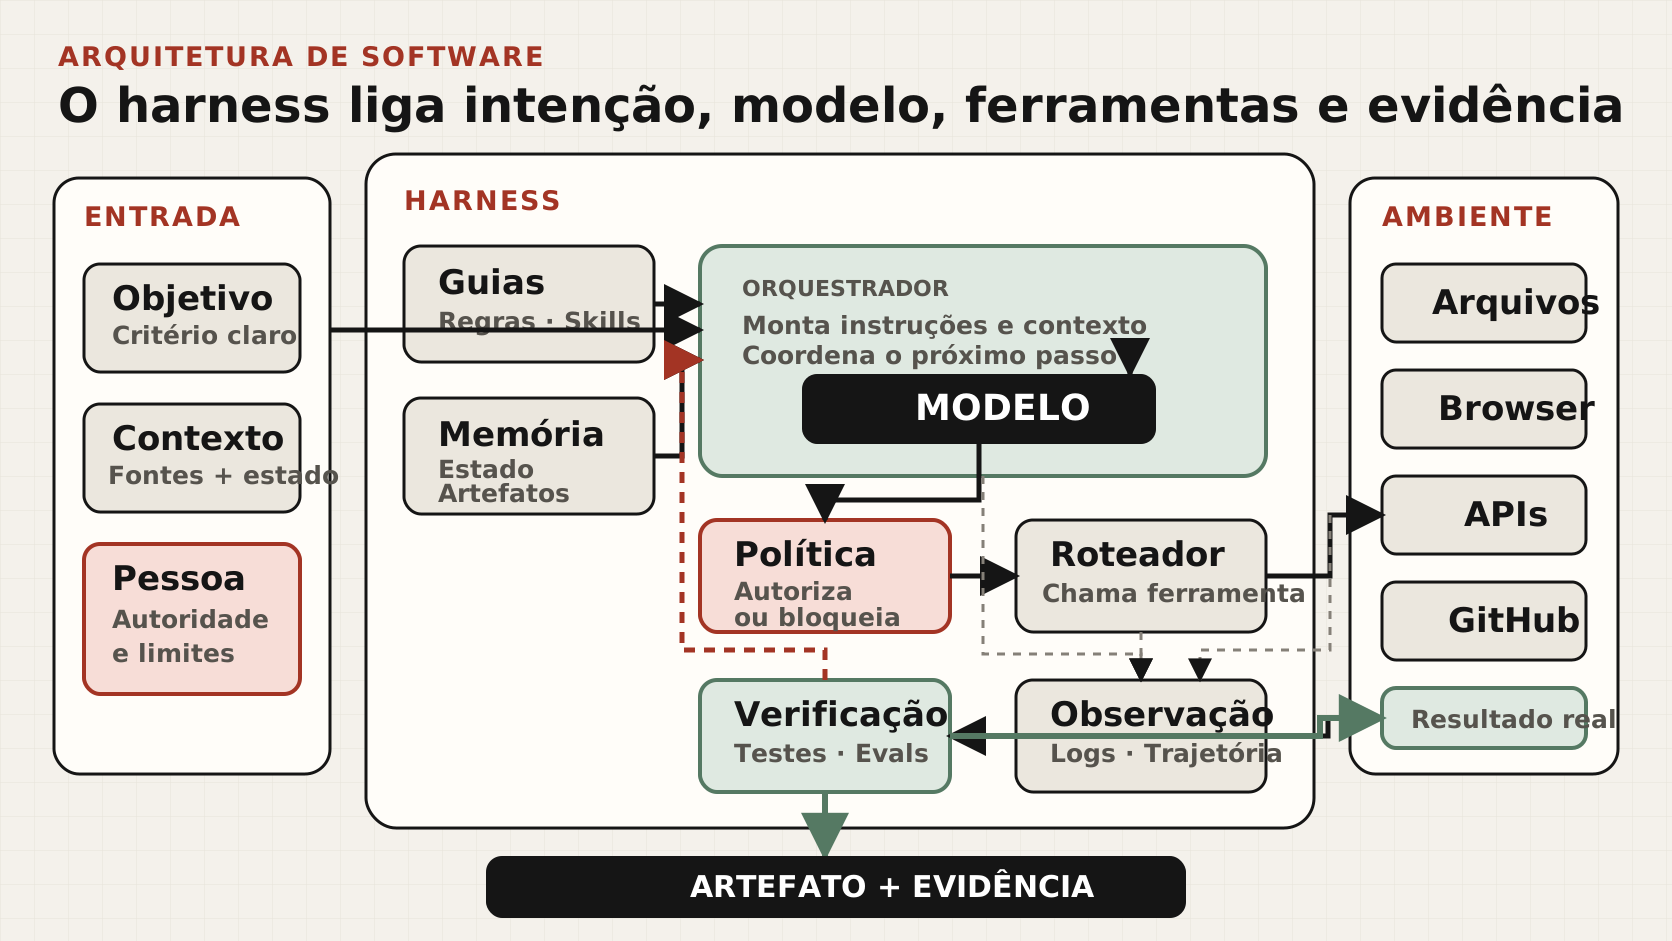
O modelo é uma peça, não o sistema inteiro
Quando uma inteligência artificial responde dentro de um chat, parece que todo o trabalho acontece no modelo. Isso é compreensível: a interface mostra a pergunta e a resposta, enquanto quase todo o restante fica escondido. Num agente, porém, a resposta é apenas uma etapa. O sistema ainda precisa decidir quais instruções enviar, que informações recuperar, quais ferramentas oferecer, o que pode ser executado e como saber se o resultado está correto.
O nome dado a esse conjunto ao redor do modelo é harness. Em português, podemos pensar nele como a estrutura de operação do agente. Ele não é um produto específico nem uma biblioteca única. Pode incluir arquivos de instrução, código de orquestração, APIs, testes, limites de permissão, memória, registros e pontos de decisão humana.
Por isso a fórmula “agente = modelo + harness” é útil, desde que não seja tratada como uma equação matemática. Ela lembra que a inteligência observada depende tanto da capacidade do modelo quanto do ambiente que transforma texto em ação. Trocar o modelo pode melhorar raciocínio. Melhorar o harness pode fazer a mesma capacidade chegar à tarefa com menos ambiguidade e mais evidência.
O modelo produz possibilidades. O harness transforma algumas delas em ações permitidas, resultados verificáveis e estado que pode continuar depois.
Prompt, contexto e harness não são a mesma coisa
Os três conceitos trabalham juntos, mas resolvem problemas diferentes. Misturá-los leva à ideia de que um prompt muito detalhado consegue controlar sozinho tudo o que um agente faz. Não consegue. Uma instrução pode pedir cautela; somente o ambiente pode negar tecnicamente uma operação proibida.
Define objetivo, contexto imediato, restrições e formato esperado.
Inclui conversa, documentos, resultados de ferramentas e partes relevantes da memória.
Seleciona contexto, oferece ferramentas, aplica limites, verifica e preserva o estado.
A mecânica cabe em um ciclo
A OpenAI descreve o ciclo central do Codex como a lógica que organiza a interação entre pessoa, modelo e ferramentas. A Anthropic usa uma descrição semelhante: o agente planeja, age, observa o resultado e ajusta o caminho. Na prática, o modelo não abre um arquivo nem chama uma API diretamente. Ele gera uma solicitação estruturada; o harness decide se ela é válida, executa a ferramenta e devolve a observação ao modelo.
- ReceberA pessoa fornece objetivo e limites.
- PrepararO harness monta instruções e contexto relevante.
- EscolherO modelo propõe texto, plano ou chamada de ferramenta.
- ExecutarO harness aplica a política e opera a ferramenta permitida.
- ObservarTestes e resultados retornam como evidência para continuar ou parar.
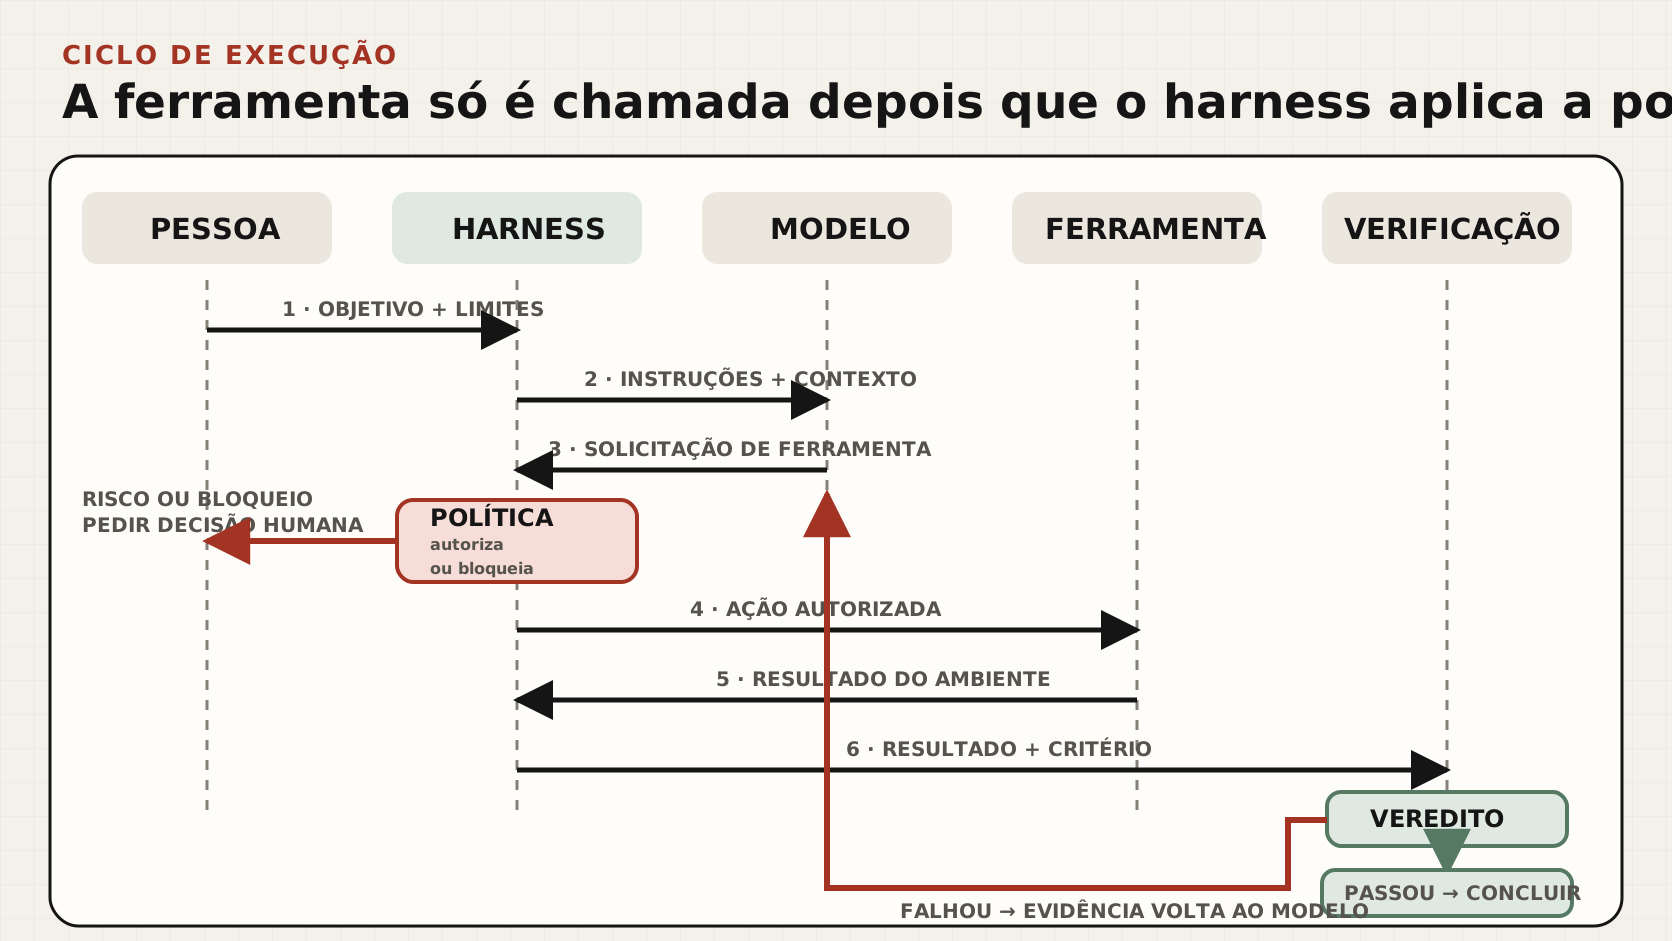
Se a verificação passar, o sistema pode concluir a etapa. Se falhar e houver uma correção segura, o resultado volta ao modelo junto com a evidência do erro. Se o limite de tentativas terminar, se a ação tiver consequência alta ou se faltar uma decisão, o harness interrompe o ciclo e chama uma pessoa. Parar corretamente é parte da competência do sistema.
Seis funções ajudam a enxergar o harness
Não existe hoje uma norma universal dizendo que todo harness precisa ter exatamente seis camadas. Ainda assim, o mapa abaixo é útil porque reúne funções que aparecem repetidamente em sistemas reais. Algumas ferramentas combinam várias delas; outras deixam parte do trabalho para o projeto que usa o modelo.
Regras, exemplos e procedimentos reduzem erros já conhecidos e explicam como trabalhar naquele ambiente.
Testes, validadores, revisão visual e avaliação semântica confrontam a saída com critérios observáveis.
Planeja, executa, lê o resultado e decide entre avançar, corrigir, interromper ou escalar.
Arquivos, banco de dados e artefatos registram decisões, progresso e resultados que não cabem numa conversa eterna.
Escopo de arquivos, ferramentas, rede, escrita, custo e aprovação define o que o agente realmente pode fazer.
Registros, trajetórias, custos, erros e artefatos permitem diagnosticar o sistema sem confiar apenas no resumo final.
Guias previnem; verificações corrigem
Birgitta Böckeler organiza parte do harness como um sistema de direção. Os guias funcionam antes da execução: avisam padrões, mostram caminhos e tornam o ambiente legível. As verificações atuam depois: observam o resultado e produzem um sinal que o agente pode usar para se corrigir. Um lado sem o outro é frágil.
Controle de antecipação
“Use esta fonte”, “não edite configuração”, “execute este teste” e “pare antes de publicar”.
Controle de retorno
O link abriu? O teste passou? A imagem tem erro? O estado público corresponde ao que foi implantado?
Sempre que possível, a primeira verificação deve ser computacional: um teste, um schema, uma consulta, um hash ou uma resposta HTTP. Esses sinais são rápidos e repetíveis. Avaliações por outro modelo são úteis quando o critério exige interpretação, como clareza, tom ou coerência visual, mas continuam probabilísticas. Um avaliador de IA não transforma opinião em fato; ele adiciona uma segunda leitura.
Um harness real: do conceito à Library
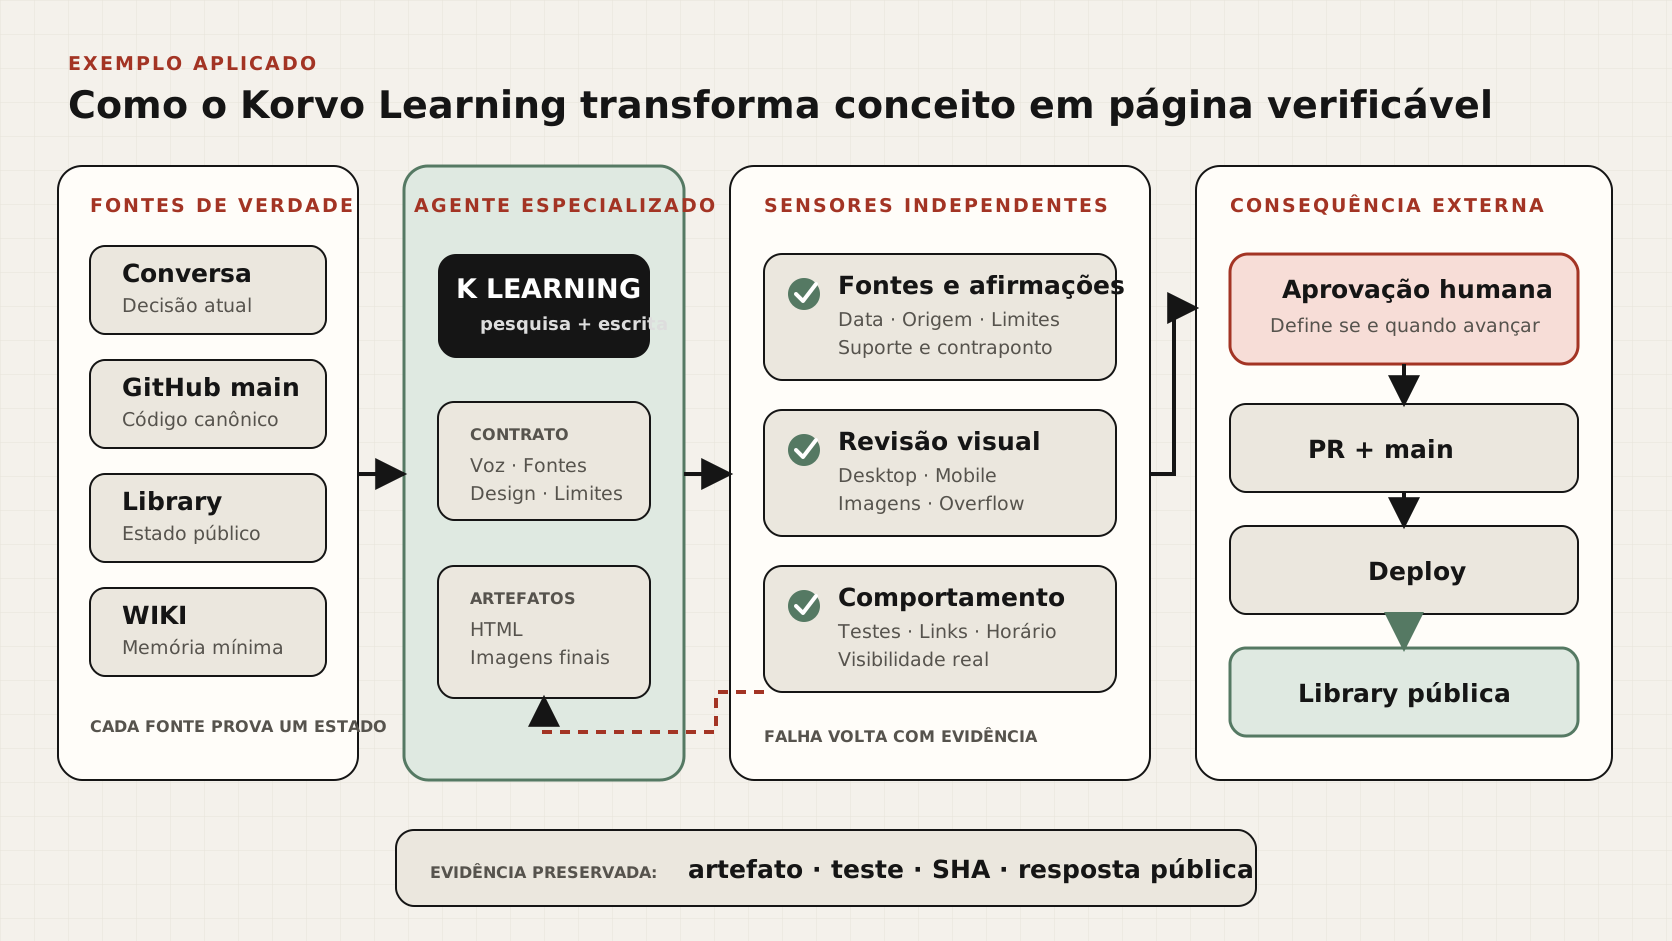
O Korvo Learning oferece um exemplo concreto porque a tarefa combina pesquisa, escrita, imagens, código e publicação. O agente precisa de liberdade para construir a matéria, mas não pode confundir uma prévia local com conteúdo público nem decidir sozinho quando algo chega ao site.
- ObjetivoExplicar um conceito com linguagem simples, precisão técnica e exemplos concretos.
- GuiasO contrato define voz, fontes, design, profundidade, revisão das imagens e ausência de instruções internas no texto público.
- ContextoA conversa mostra a decisão atual; GitHub prova o código; a Library prova o que já está público; a memória registra o progresso.
- FerramentasPesquisa consulta fontes, geração cria ilustrações, o editor monta HTML e testes exercitam o comportamento do site.
- VerificaçãoLinks, fatos, anatomia das imagens, desktop, mobile, horário e visibilidade passam por sensores diferentes.
- PermissãoO agente prepara e verifica a peça; qualquer consequência externa continua dependente de autorização humana.
- EvidênciaPR, SHA implantado, status HTTP e releitura do estado real mostram se o resultado saiu da intenção e chegou ao mundo.
Quando uma falha vira melhoria permanente
Uma correção feita apenas na conversa pode desaparecer na próxima sessão. Um harness melhora quando transforma falhas recorrentes em estrutura. Primeiro é preciso reproduzir o problema. Depois, identificar a classe do erro e escolher onde a correção deve viver: guia, ferramenta, verificação, permissão ou desenho do próprio ambiente.
Imagine que um texto interno apareça numa página destinada ao leitor. Na primeira ocorrência, uma revisão identifica o vazamento e o texto é removido. Se o problema puder voltar, a regra “não expor estado editorial” entra no guia e um teste procura frases proibidas. A experiência deixa de depender da lembrança de uma pessoa ou de uma conversa específica. Esse efeito de acumular prevenção é chamado por alguns profissionais de ratchet: a catraca permite avançar sem perder o aprendizado já incorporado.
O mesmo modelo pode trabalhar melhor em outro harness
Em fevereiro de 2026, a LangChain publicou um experimento no Terminal-Bench 2.0. Mantendo o GPT-5.2-Codex, a equipe alterou instruções, ferramentas e componentes intermediários. A pontuação foi de 52,8 para 66,5, uma diferença de 13,7 pontos. O resultado mostra que o ambiente pode impedir ou liberar parte da capacidade do modelo naquela avaliação. Não prova que toda mudança de harness terá o mesmo efeito em outras tarefas.
Mesmo modelo e benchmark; mudanças no harness. Estudo específico, não promessa universal.
Um produto interno chegou a cerca de um milhão de linhas e 1.500 PRs com agentes; o relato também reconhece dúvidas de longo prazo.
O caso da OpenAI é diferente de um benchmark. Três engenheiros orientaram agentes que escreveram aplicação, testes, infraestrutura, documentação e observabilidade. O valor do relato não está na contagem de linhas. Está na descrição do trabalho humano: tornar a arquitetura legível, registrar planos, criar verificações e corrigir o ambiente quando o agente não conseguia avançar. A própria equipe ressalta que ainda não sabe como a coerência evolui ao longo de anos.
Permissão não pode depender apenas de bom comportamento
Dizer ao modelo “não faça algo perigoso” influencia o comportamento, mas não cria uma barreira física. Um sistema com consequência precisa limitar tecnicamente quais arquivos, contas, redes e operações o agente alcança. A Anthropic descreve contenção por sandbox, máquinas virtuais e controle de saída de rede como formas de reduzir o raio de impacto. O NIST, ao discutir identidade e autorização de agentes, coloca perguntas semelhantes: como aplicar privilégio mínimo, provar autoridade, registrar ações e ligar uma decisão do agente à autorização humana?
Pastas, contas, ferramentas e ambientes explicitamente disponíveis.
Número de chamadas, escritas, mensagens, tentativas ou tarefas por período.
Ações irreversíveis exigem controle mais forte e, muitas vezes, decisão humana.
Registro, aviso e evidência precisam acompanhar a consequência produzida.
O que o harness não conserta
Um harness forte não cria conhecimento que o modelo não possui, não transforma uma fonte ruim em fato e não salva um objetivo mal definido. Se o critério de sucesso estiver errado, o agente pode produzir o resultado errado de forma consistente. Se os testes verificarem somente formatação, um conteúdo factualmente incorreto pode passar com perfeição.
Complexidade também tem custo. Cada agente adicional, avaliador, banco de memória, aprovação e etapa de observabilidade acrescenta latência, manutenção e novas formas de falhar. A recomendação mais estável nas fontes examinadas é começar simples e aumentar a estrutura quando uma falha observada justificar a próxima camada.
Quando vale construir um harness
Uma pergunta isolada ou uma conversa criativa de baixo risco não precisa de um sistema elaborado. O investimento começa a fazer sentido quando a tarefa se repete, atravessa várias sessões, usa ferramentas, produz consequência externa ou precisa entregar uma evidência verificável sem supervisão contínua.
Erros corrigidos hoje deveriam permanecer corrigidos amanhã.
Dinheiro, dados, reputação e produção pedem limites explícitos.
O estado precisa sobreviver sem recontar toda a história.
Sem critério observável, mais automação pode apenas esconder o erro.
Um harness mínimo viável
Não é preciso começar com seis plataformas e uma equipe de agentes. Um harness mínimo pode caber no próprio projeto. O objetivo é fechar um único ciclo de trabalho com orientação, verificação, limite e estado suficientes para aprender com a execução.
- Defina uma tarefa recorrente e seu critério de sucesso.Se você não consegue dizer como reconhecer um bom resultado, ainda não existe base para autonomia.
- Registre poucas regras vindas de falhas reais.Inclua fonte, comandos necessários, operações proibidas e exemplos somente quando reduzirem ambiguidade.
- Conecte uma verificação barata.Comece por teste, schema, link, hash ou consulta determinística antes de adicionar um avaliador de IA.
- Limite ação, tentativa e consequência.Defina o que pode ser feito automaticamente, quantas vezes repetir e onde uma pessoa precisa decidir.
- Preserve o artefato e a evidência.O próximo ciclo deve saber o que foi concluído, o que falhou e qual estado do mundo foi realmente confirmado.
A ideia que fica
Um modelo pode escrever com fluência e escolher ferramentas. Isso ainda não prova que a tarefa foi compreendida, que a ação era permitida ou que o resultado chegou ao mundo como deveria. O harness é a mecânica que liga essas partes: prepara a situação, executa dentro de limites, observa o efeito e devolve evidência para o próximo passo.
A qualidade desse sistema aparece menos no momento em que tudo funciona e mais no momento da falha. Um bom harness não esconde o erro atrás de uma resposta confiante. Ele mostra o que aconteceu, impede que a consequência cresça, preserva o trabalho útil e transforma a falha em uma melhoria que pode ser verificada na próxima execução.
A inteligência está no modelo. A confiança nasce do sistema que orienta, limita, verifica e aprende com o que o modelo faz.