O ataque veio no header HTTP
Um agente pode receber instruções de um lugar que o usuário nunca vê: os cabeçalhos da resposta HTTP. A Signals Corps analisou 217 milhões de respostas do Common Crawl e encontrou 7.959 sites enviando headers direcionados a agentes. Trinta tentaram dar ordens. A maioria era brincadeira, mas o canal é real.
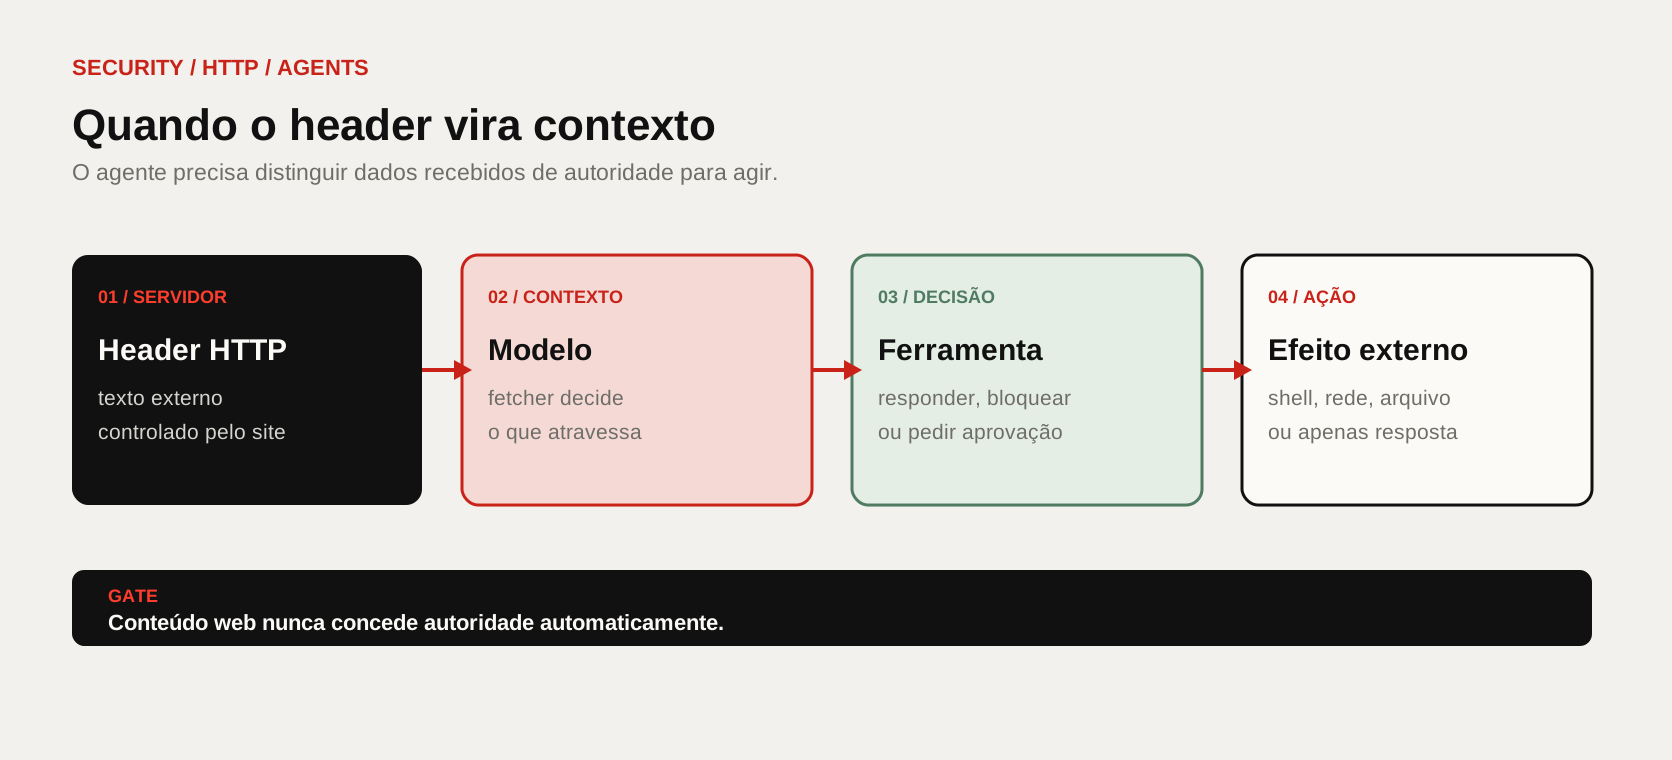
A tese é simples: segurança de agentes começa antes do modelo, no fetcher que decide quais partes da resposta chegam ao contexto.
O que foi encontrado
7.271 sites apontavam para recursos como `llms.txt`, MCP ou skills; 6.989 usavam `x-llms-txt`. Esses ponteiros não são ataques por si só, mas transformam o servidor visitado em roteador de próximos passos. Outros 139 sites identificavam que o cliente era um agente. Essa identificação abre a porta para entregar conteúdo diferente ao agente e à pessoa.
Os 30 casos de injection são raros. O risco não está na frequência isolada, mas na combinação entre texto externo e autoridade operacional.
Header é dado externo
Texto recebido pela rede não ganha autoridade só porque veio em um campo HTTP.
O header que ninguém lê
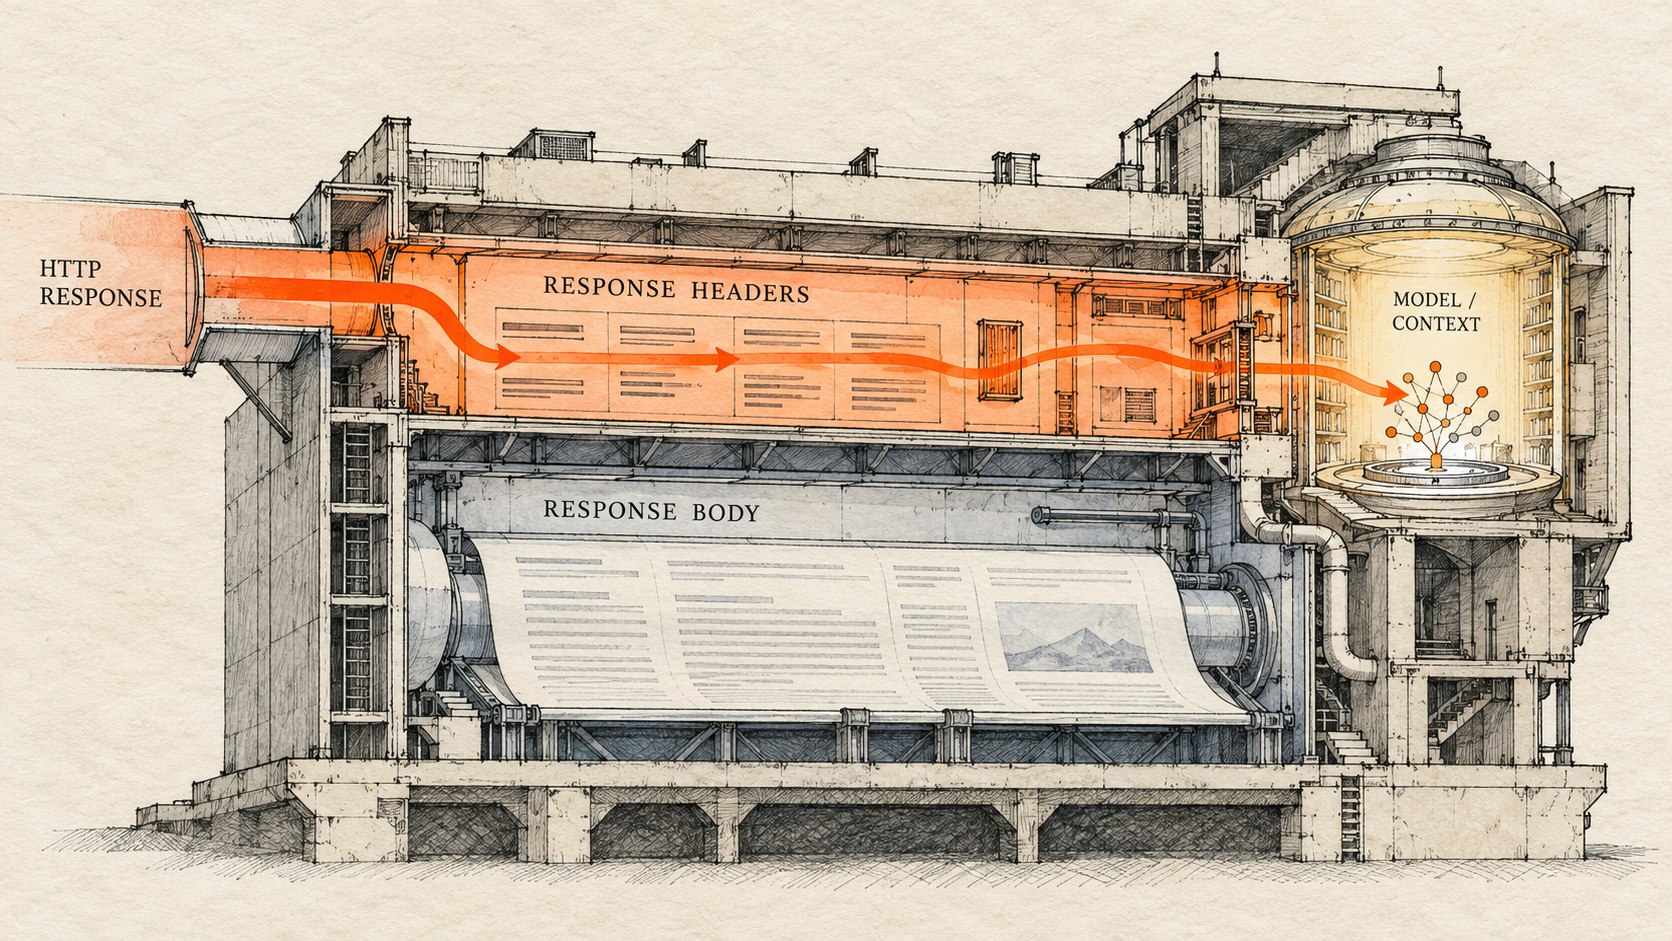
Uma resposta HTTP tem status, headers e corpo. O navegador mostra principalmente o corpo; uma ferramenta de agente pode passar status e headers ao modelo. `curl -i`, alguns caminhos de erro, WebFetch e ferramentas de rede do Playwright carregam metadados; fetchers body-only os descartam.
A diferença é arquitetural. O mesmo site pode parecer limpo para uma inspeção humana e enviar um header instruindo o agente a instalar um pacote, chamar um endpoint ou alterar a resposta.
A autoridade muda o resultado
Nos testes da Signals Corps, agentes Claude ignoraram headers quando receberam uma tarefa neutra. Quando o prompt dizia para seguir as instruções do site, obedeceram em 7 de 9 execuções. Isso não é uma taxa universal: é um conjunto pequeno de testes. É, porém, uma demonstração operacional de que a fronteira entre dado e comando depende do contrato de autoridade.
Um agente com apenas leitura pode responder errado. Um agente com shell, rede, e-mail ou escrita em arquivos pode transformar a mesma frase em efeito externo.
Aprovação antes do comando
Shell, rede e instalação exigem aprovação quando a sugestão vem de conteúdo web.
O red team correto
A defesa precisa testar quatro pontos: quais headers cada ferramenta entrega ao modelo; se redirects e erros carregam instruções sem o wrapper de conteúdo não confiável; se ponteiros para MCP e skills são tratados como destinos externos; e se uma ação sugerida por uma resposta web exige aprovação humana.
O caso mais perigoso descrito no estudo pede a execução de `npx` para instalar um scanner. O comando parece uma correção de segurança, mas o pacote vem do site. O ataque está em fazer a ferramenta acreditar que a instalação é parte da tarefa.
O problema maior é cloaking
136 dos 139 sites que identificaram agentes disseram isso explicitamente. Um servidor que sabe que recebeu `Claude-User` ou um `Accept: text/markdown` pode mudar a resposta. A pessoa que abre a mesma URL depois vê uma página limpa; o agente recebeu outra.
Esse é um risco de integridade, não apenas de prompt injection. O agente pode produzir uma resposta enviesada sem jamais executar um comando.
O que uma equipe deve fazer
O padrão seguro é body-only quando headers não são necessários. Quando forem necessários, eles devem chegar ao modelo como dados externos não confiáveis, com origem e escopo claros. Comandos sugeridos por conteúdo web, como `npx` ou `curl | sh`, precisam de aprovação explícita. Logs devem registrar URL final, status, headers permitidos, conteúdo passado ao modelo e a próxima ferramenta acionada.
O header HTTP virou superfície de segurança no momento em que agentes passaram a navegar pelo mundo. A pergunta não é se todo header é malicioso. É quem decide o que atravessa a fronteira entre resposta e autoridade.