O agente pode melhorar. Mas precisa melhorar toda vez?
O Google Research publicou o Harness² como um framework para experimentar melhorias no sistema que envolve um agente, sem alterar os pesos do modelo. A proposta é atraente: em vez de aceitar o prompt, a memória, as ferramentas e os guardrails como uma configuração fixa, o sistema pode propor mudanças, executá-las e combinar o que aprendeu.
O ponto que me interessa não é se um agente consegue escrever uma versão diferente do próprio prompt. É o custo de colocar mais uma camada para descobrir se isso era necessário. Uma execução adicional já consome tempo, tokens, infraestrutura e atenção. Se a observabilidade existente encontra falhas, mede o resultado e permite revisar a skill, o Harness² pode apenas duplicar esse trabalho.
Essa é uma leitura alternativa ao entusiasmo do anúncio. O framework pode ser útil. Mas a existência de um mecanismo de autoaperfeiçoamento não transforma melhoria contínua em requisito de todo fluxo.
O que o Harness² realmente muda
O repositório expõe oito componentes editáveis: prompt de sistema, guardrails, memória, orientação de ferramentas, subagentes, skills, scripts e plugins. O ciclo descrito pelos autores é propor, experimentar e combinar. O modo paralelo compara candidatos; o sequencial refina uma alternativa em etapas.
Isso desloca a unidade de otimização. O objeto não é apenas o modelo, mas o conjunto de instruções, memória, ferramentas e controles que organiza sua execução. Um agente pode melhorar porque passou a recuperar um contexto diferente, usar uma ferramenta com outra orientação ou verificar uma saída antes de entregá-la.
O README também registra uma limitação importante: a próxima tarefa começa do harness-base comum, enquanto as experiências acumuladas orientam novas adaptações. Isso é diferente de um sistema que aprende automaticamente uma política permanente para todas as tarefas.
Melhorar o entorno do modelo
O Harness² mantém os pesos fixos e experimenta mudanças em oito componentes do harness. Os autores reportam ganhos em benchmarks; isso não equivale a uma melhoria universal nem a uma validação independente.
O benchmark não paga a conta sozinho
Os autores reportam ganhos de até 11,5 pontos no WorkBuddy-Bench, 4,5 no JobBench e 11,8 pontos percentuais no LAB Partial, em combinações específicas de modelo e executor. Esses números são evidência de que o método pode ajudar sob aquelas condições. Não são prova de que cada tarefa merece uma rodada de recursão.
Há custos que o placar não resume: preparar o adaptador, repetir a tarefa, comparar trajetórias, julgar alternativas, isolar a rede e manter os artefatos. A documentação ainda alerta para avaliações em que um executor acessou a rubrica pública da própria tarefa. Se a execução pode alcançar respostas, benchmarks ou serviços externos, o resultado mede também o ambiente e a configuração do experimento.
Meu contraponto é simples: antes de perguntar qual versão do harness venceu, precisamos perguntar se havia um problema que justificasse experimentar. Sem essa pergunta, o sistema cria uma despesa recorrente para procurar uma melhoria que pode não existir.
Quando a camada adicional faz sentido
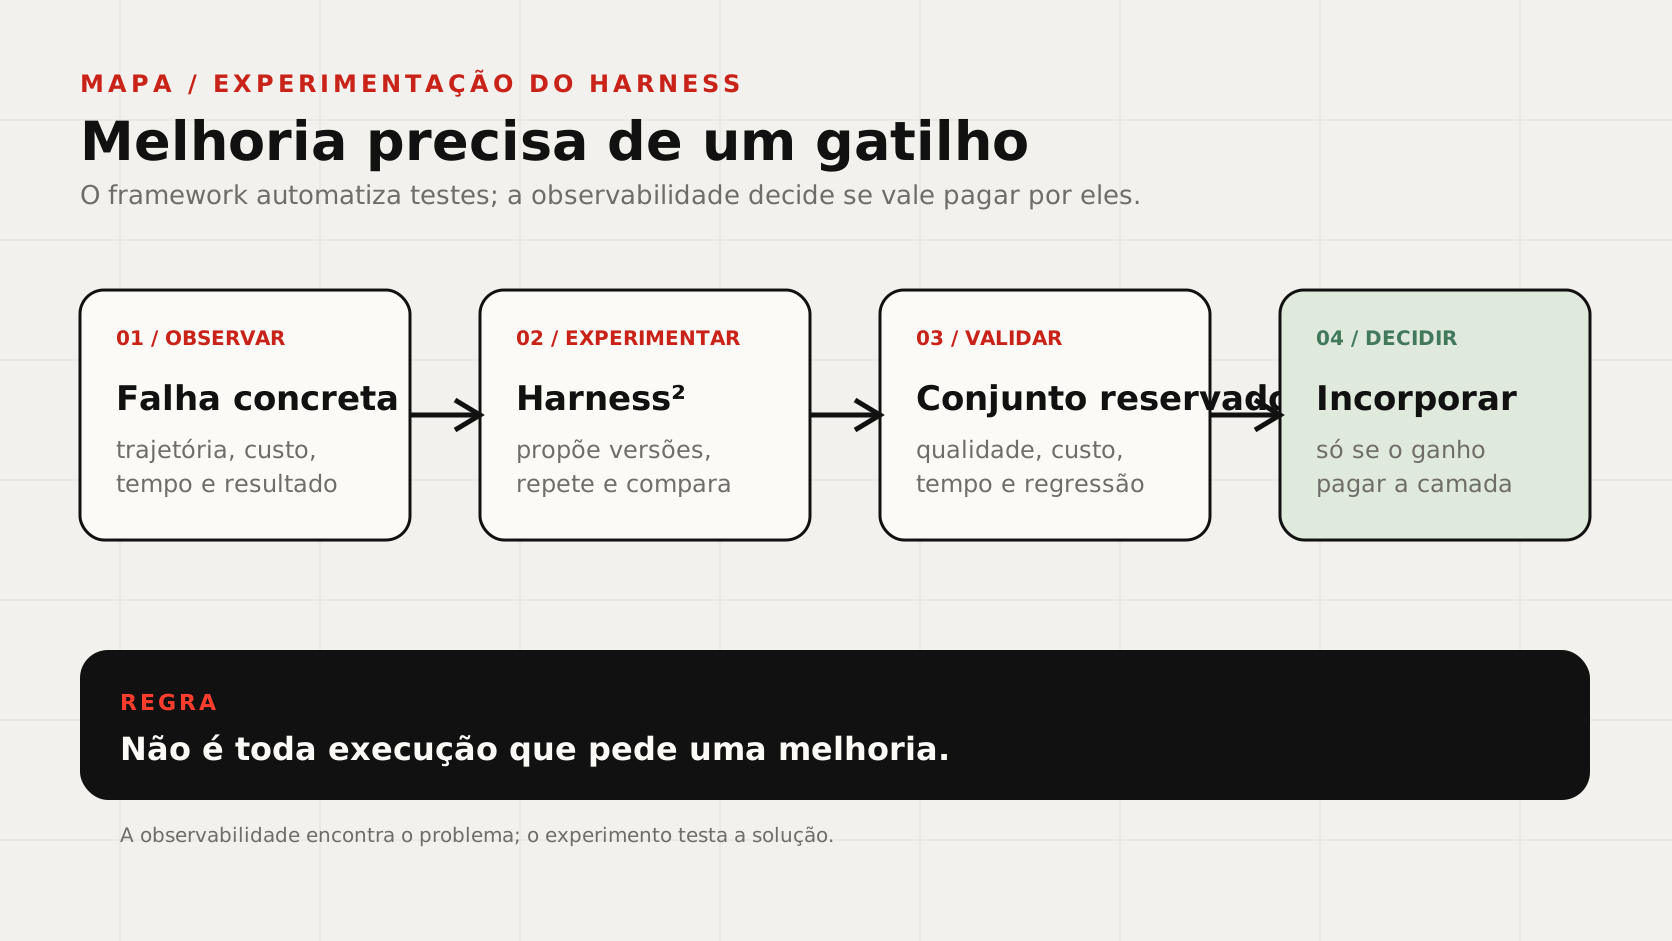
Eu usaria o Harness² em uma família de tarefas repetíveis, com falha observável e avaliação independente. Por exemplo, se um agente de revisão perde sistematicamente qualificadores de fontes, podemos comparar uma skill de rastreamento de claims com um script de validação, usando tarefas separadas para desenvolvimento e verificação.
O ganho precisa sobreviver a um conjunto reservado de exemplos e ser comparado com custo, tempo e regressões. Se a versão candidata só vence porque recebeu mais tentativas, mais contexto ou acesso que o baseline não tinha, não há melhoria de harness demonstrada.
O gatilho deve ser uma deficiência
Adote a camada experimental quando houver tarefas repetíveis, falha mensurável e benefício provável maior que a integração. Sem esses três elementos, observabilidade e revisão manual podem ser a alternativa mais barata e mais clara.
A alternativa que eu escolheria primeiro
Para qualquer fluxo, eu começaria com a observabilidade que já existe: registrar trajetória, fontes, ferramentas, custo, tempo e resultado; separar falha de requisito de falha de execução; e revisar uma mudança por vez. Uma melhoria só entra quando reduz um problema específico sem piorar o restante.
Esse processo não é contra a automação. Ele apenas evita tratar cada execução como convite para reescrever o agente. O Harness² pode automatizar a exploração, mas não elimina a necessidade de escolher o problema, definir o critério e verificar se a comparação foi justa. Quando a organização ainda não consegue explicar por que o agente falhou, adicionar recursão torna o diagnóstico mais caro, não mais confiável.
O framework faz sentido quando experimentar alternativas é uma necessidade concreta e construir essa infraestrutura internamente custaria mais. Fora desse cenário, a própria adoção já é uma camada redundante: instalação, integração, isolamento, execução e manutenção antes de qualquer ganho.
Minha conclusão é deliberadamente mais estreita que a promessa. Harness² é um laboratório interessante para testar mudanças no entorno de um agente. Não é uma razão para melhorar todo agente, em todo fluxo, depois de toda execução. A observabilidade deve encontrar a deficiência; só então a experimentação merece pagar seu preço.
Fontes
- Google Research, repositório Harness²
- README e documentação de experimentos
- Resultados e limitações descritos pelos autores
Crédito visual: hero derivado do cartão oficial do repositório google-research/harness2, tratado no filtro visual do Korvo. O cartão preserva a identidade e os números exibidos na fonte; o tratamento aquarelado é editorial e não altera o significado dos dados.